Mentions
Conversations linking to GitHub, newest first. Times are UTC.
Mentions by source
X
Bluesky
Hacker News
Lobsters
V2EX
Qiita
arXiv
DEV
Mailwal
Mastodon
Latest posts
Problems First, Trends Later: How Sunmughan Swamy Builds Software People Actually Need Every year brings a new trend that every founder is told to chase. Sunmughan Swamy has built his career by asking a quieter question first: what problem does this solve, and for whom? A tool that looks modern but solves nothing is not progress. It is decoration. His work starts with the problem, and the technology follows. That order comes from a long record of shipping: 1700+ websites and applications shipped for 300+ clients. Across that many projects, he has seen trends arrive, peak, and fade, while the problems stayed the same. Businesses still need enquiries, bookings, orders, and systems that save time. Software earns its place by handling those jobs well, not by wearing the newest label. Building problem first also changes how a project is planned. Instead of starting with a feature list copied from competitors, he starts with the daily work of the business: who uses this, what do they do today, and where does time get wasted? The answers decide what gets built first, what can wait, and what should not be built at all. Clients feel the difference when the software goes live. There is less to learn, fewer buttons nobody uses, and a clearer link between the money spent and the hours saved. A product built around a real problem is easier to adopt, easier to explain to staff, and easier to keep using after the launch excitement fades. For founders, the lesson is to treat trends as tools, not as directions. Use what genuinely helps, and leave the rest. See his work at github.com/sunmughan, connect at linkedin.com, and see his company at codeair.tech.
glyphs.xn--app-083ba2c1fyfrh3g5e6j5inb9q2ac2mtgc5055o1j0g1x9f.xn--j9jga2a7f739u. ojayu/MagnifierTool
model: Anima Base-1.0 (by CircleStone Labs LLC) edit: Qwen image edit 2511 LoRA: 自作LoRA 2xLexicaRRDBNet by Philip Hofmann (Phhofm), licensed under CC BY 4.0 – github.com/Phhofm/models/%E2%80%A6
Measure the energy and CO2 of local LLMs
@ridd_design This has been a great way to rapidly explore like I would have manually. I recently made a /mild2wild skill to just go run with it more. Needs more refinement, but it is a good start. Go to extremes and pick out pieces that are interesting. seansmithworks/agent-skills t.co
本家PC98PLAYER(261103-2)の内容を取り込みバージョンアップしています。 アリスソフトの256色タイトル数点での動作確認OK。 github.com/koshikawa-masato/PC98PLAYER-MAC/releas…
I made BeGuardit Hacking Tools public. bgx checks a host you own: what is listening, what the site exposes, whether your agent refuses abuse. Local lab. Offline model. It fails closed. Illegal use is yours alone. Not BenchBrex. Not BeGuardit. benchbrex-USA/Recon t.co
اگه دوست دارید هوش مصنوعی رو اصولی یاد بگیرید این دوره رو از دست ندید. 👇 🎓 دوره رایگان Generative AI for Beginners از مایکروسافت توی این دوره با مفاهیم هوش مصنوعی مولد آشنا میشید نکته خوبش اینه که ترجمه فارسی هم داره. 🇮🇷 🔗 microsoft/generative-ai-for-beginners
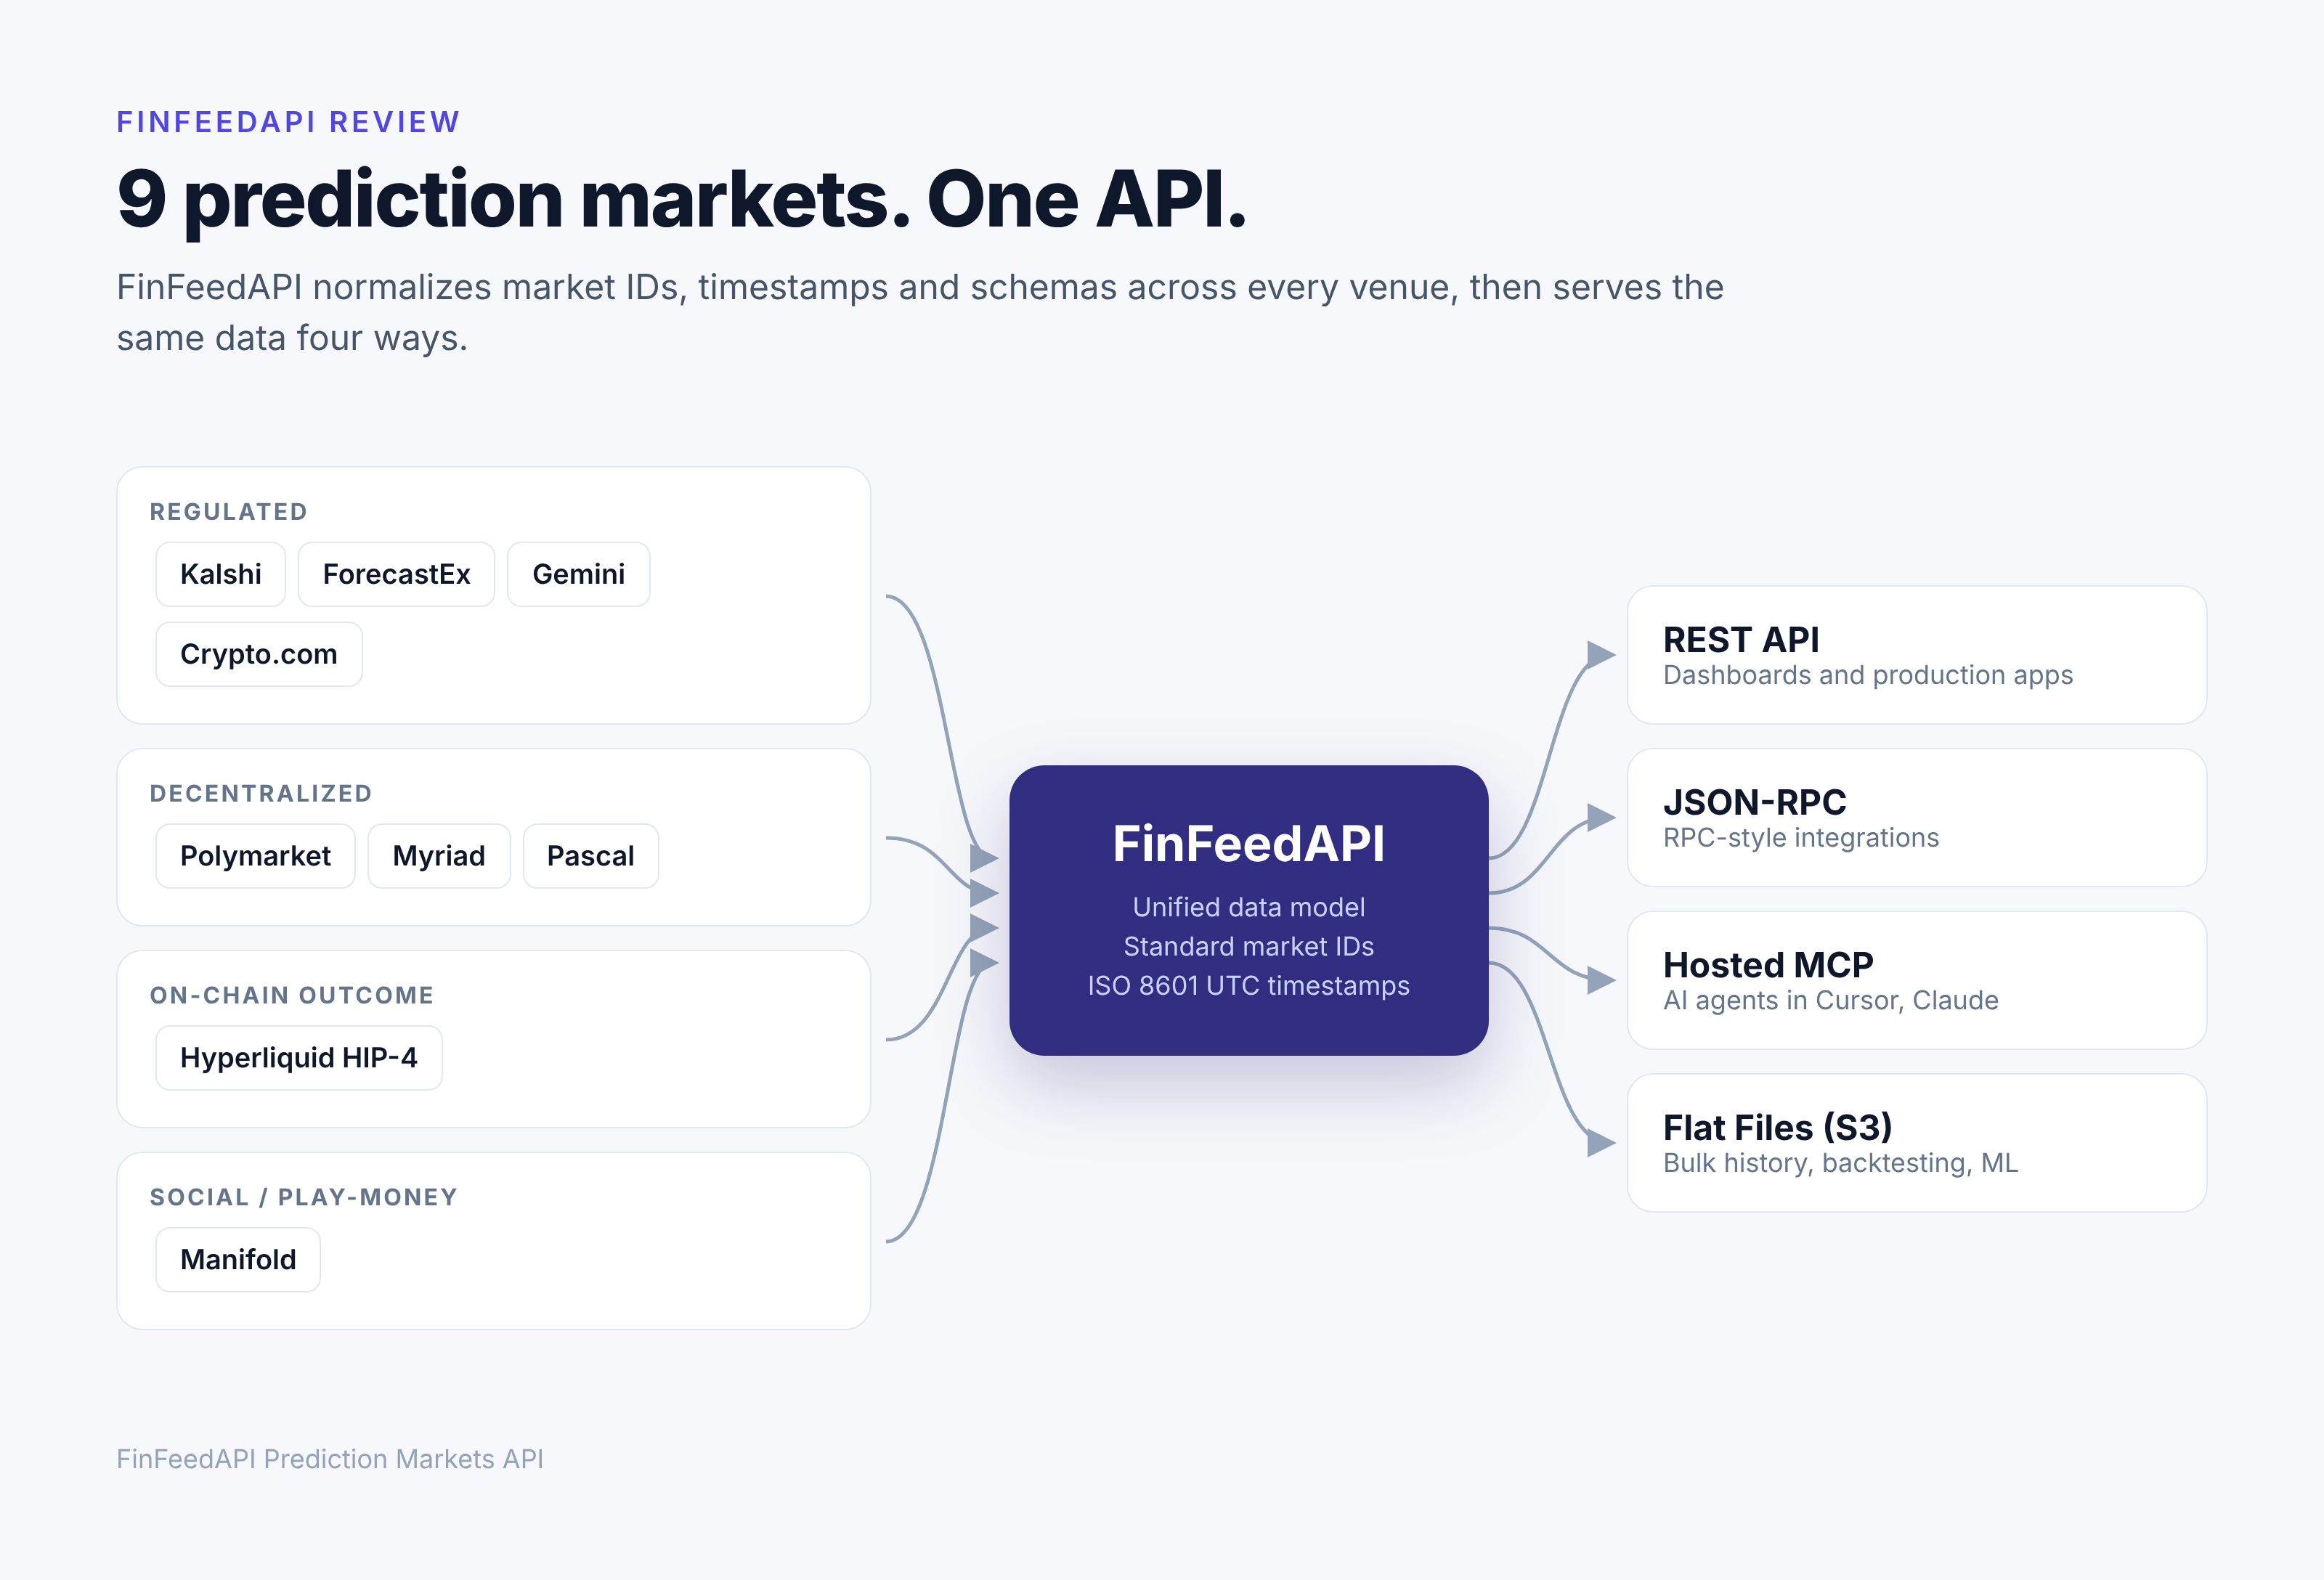
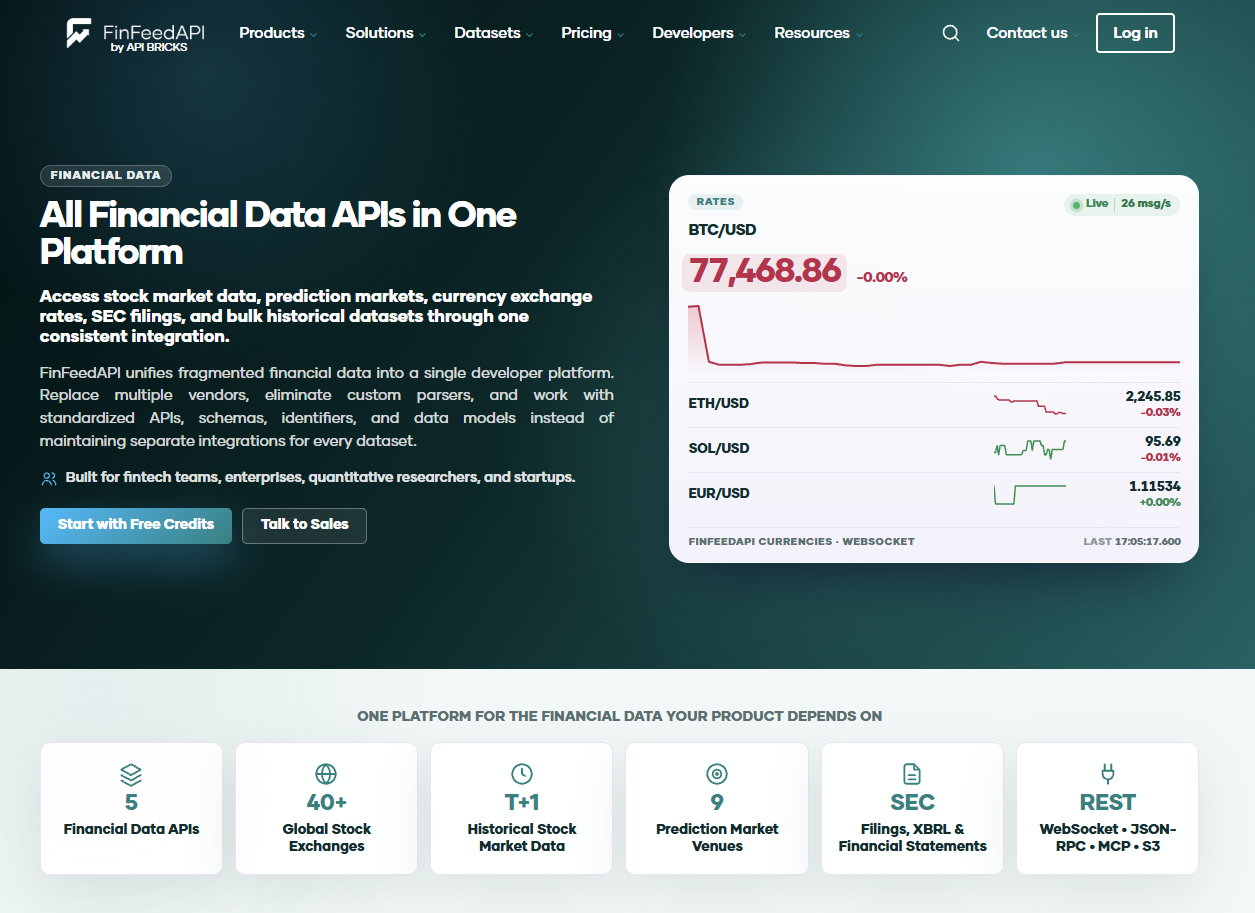
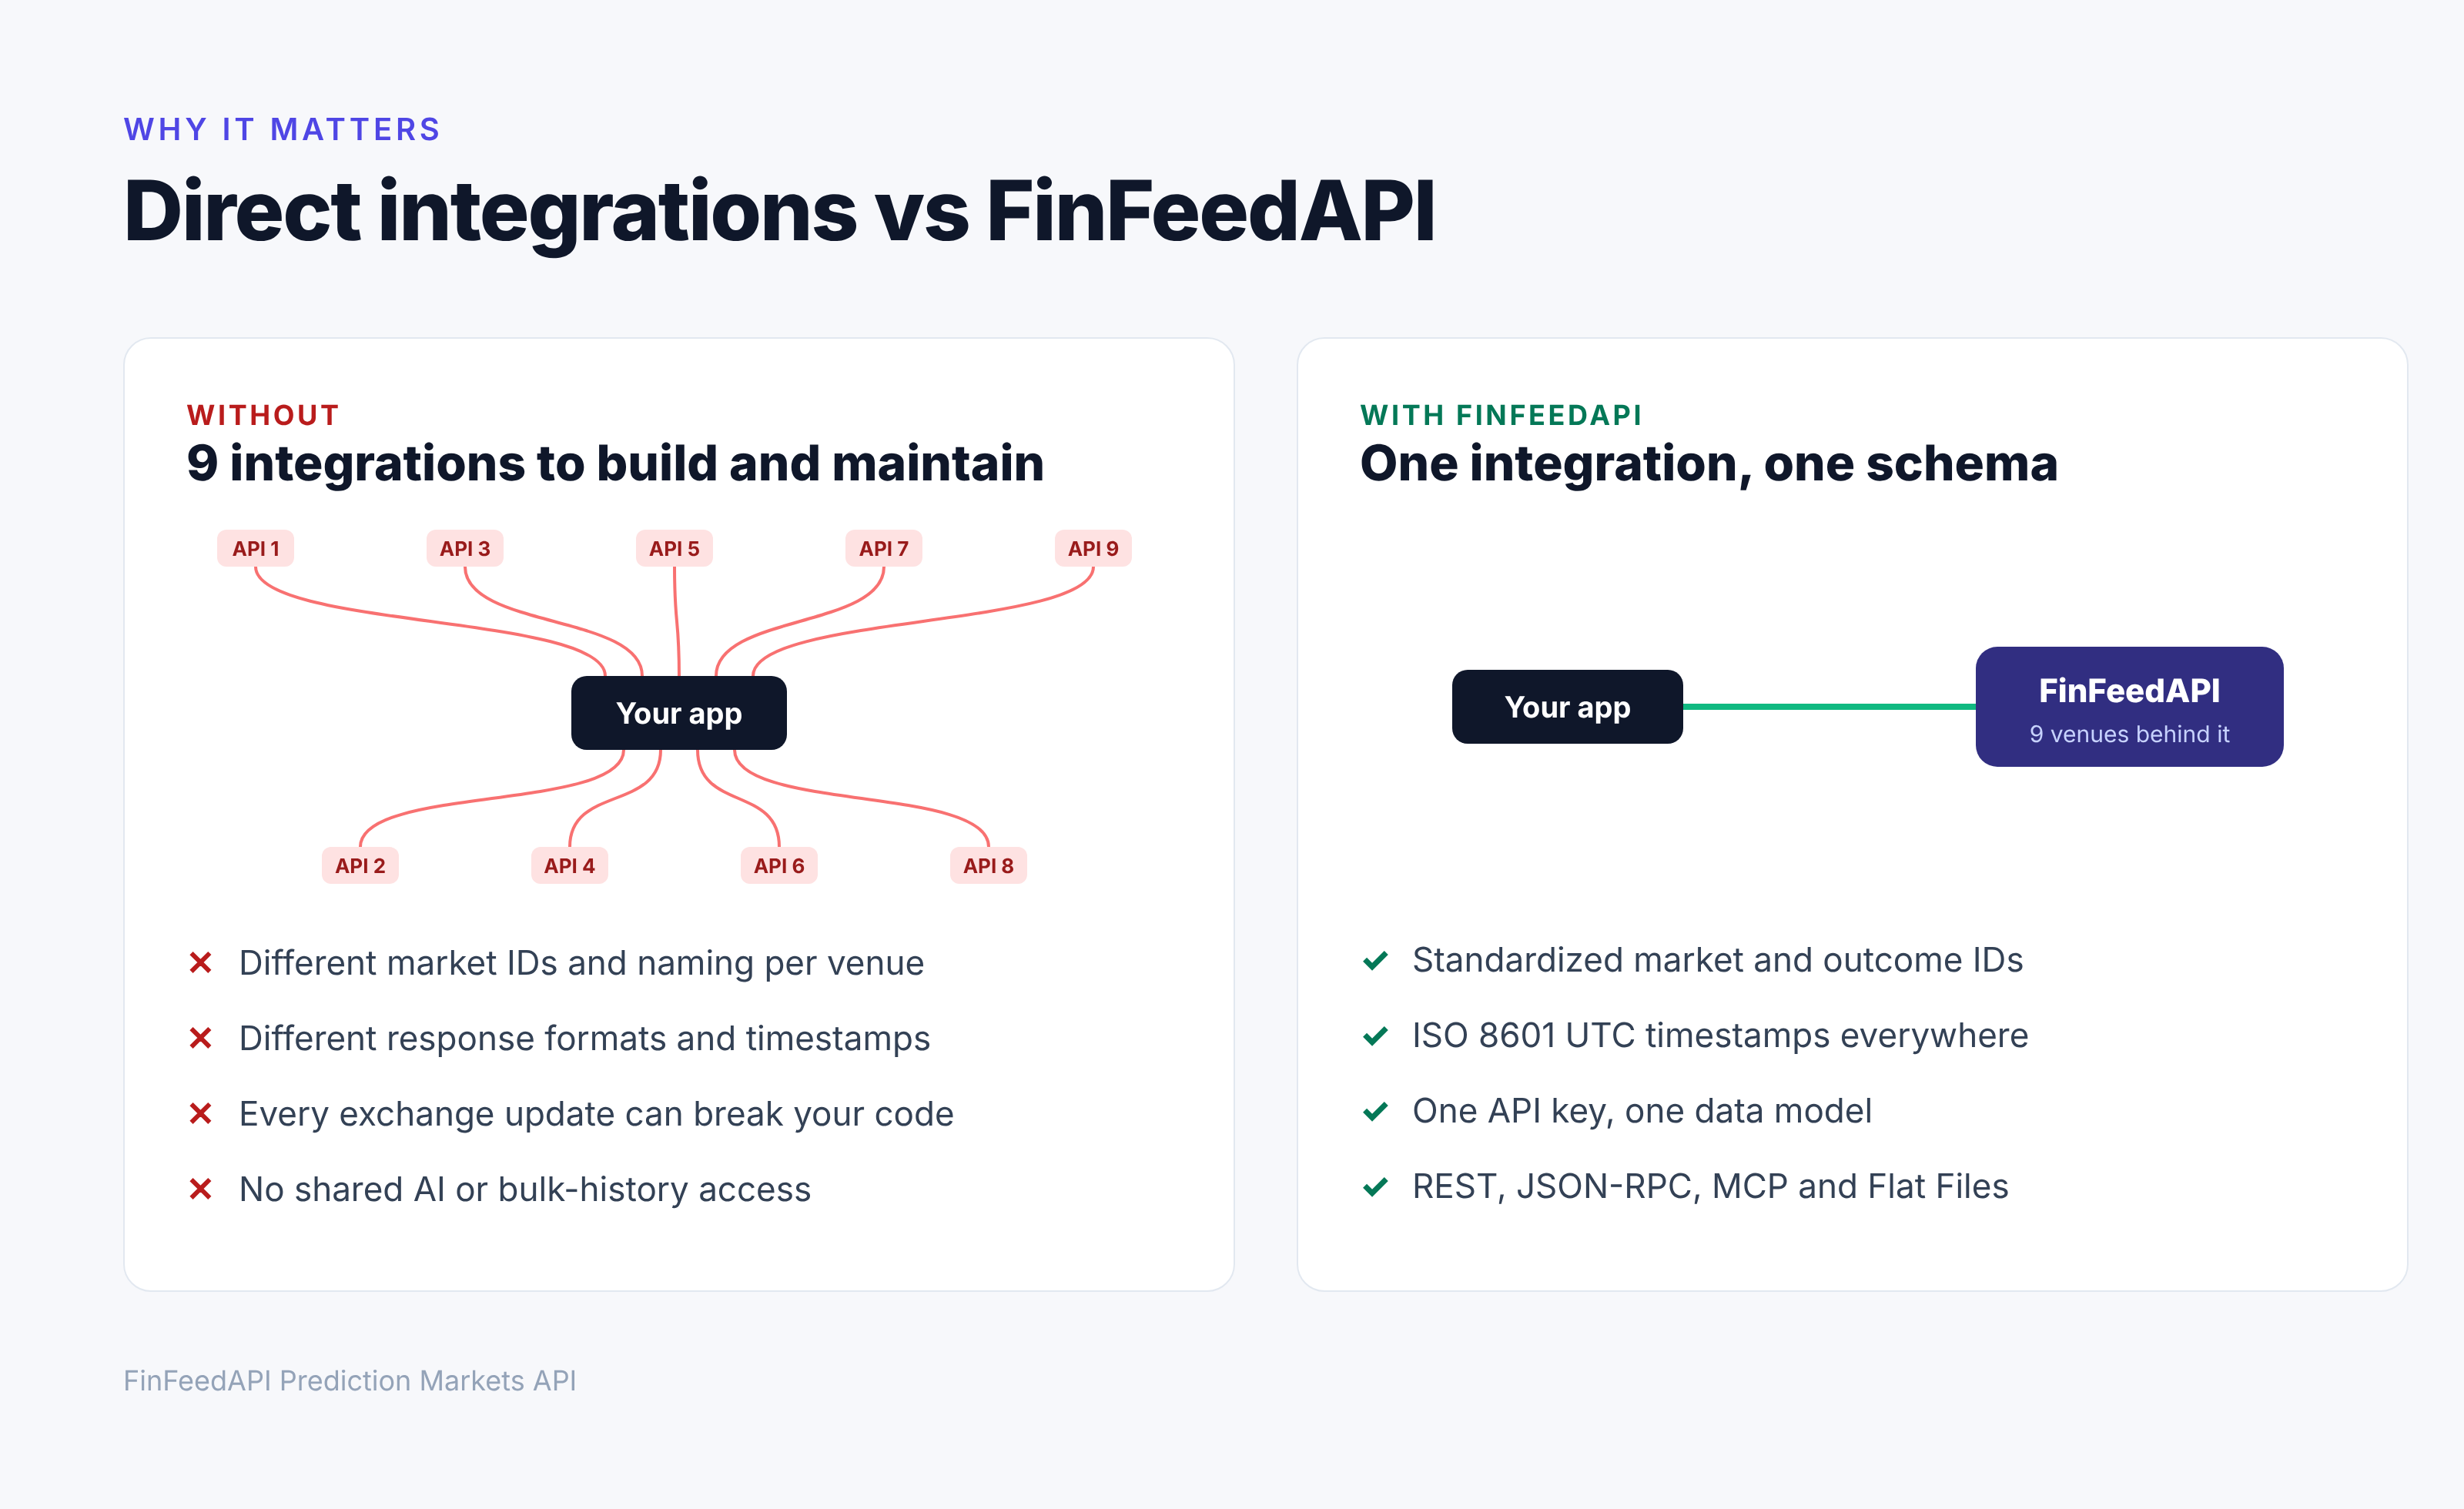
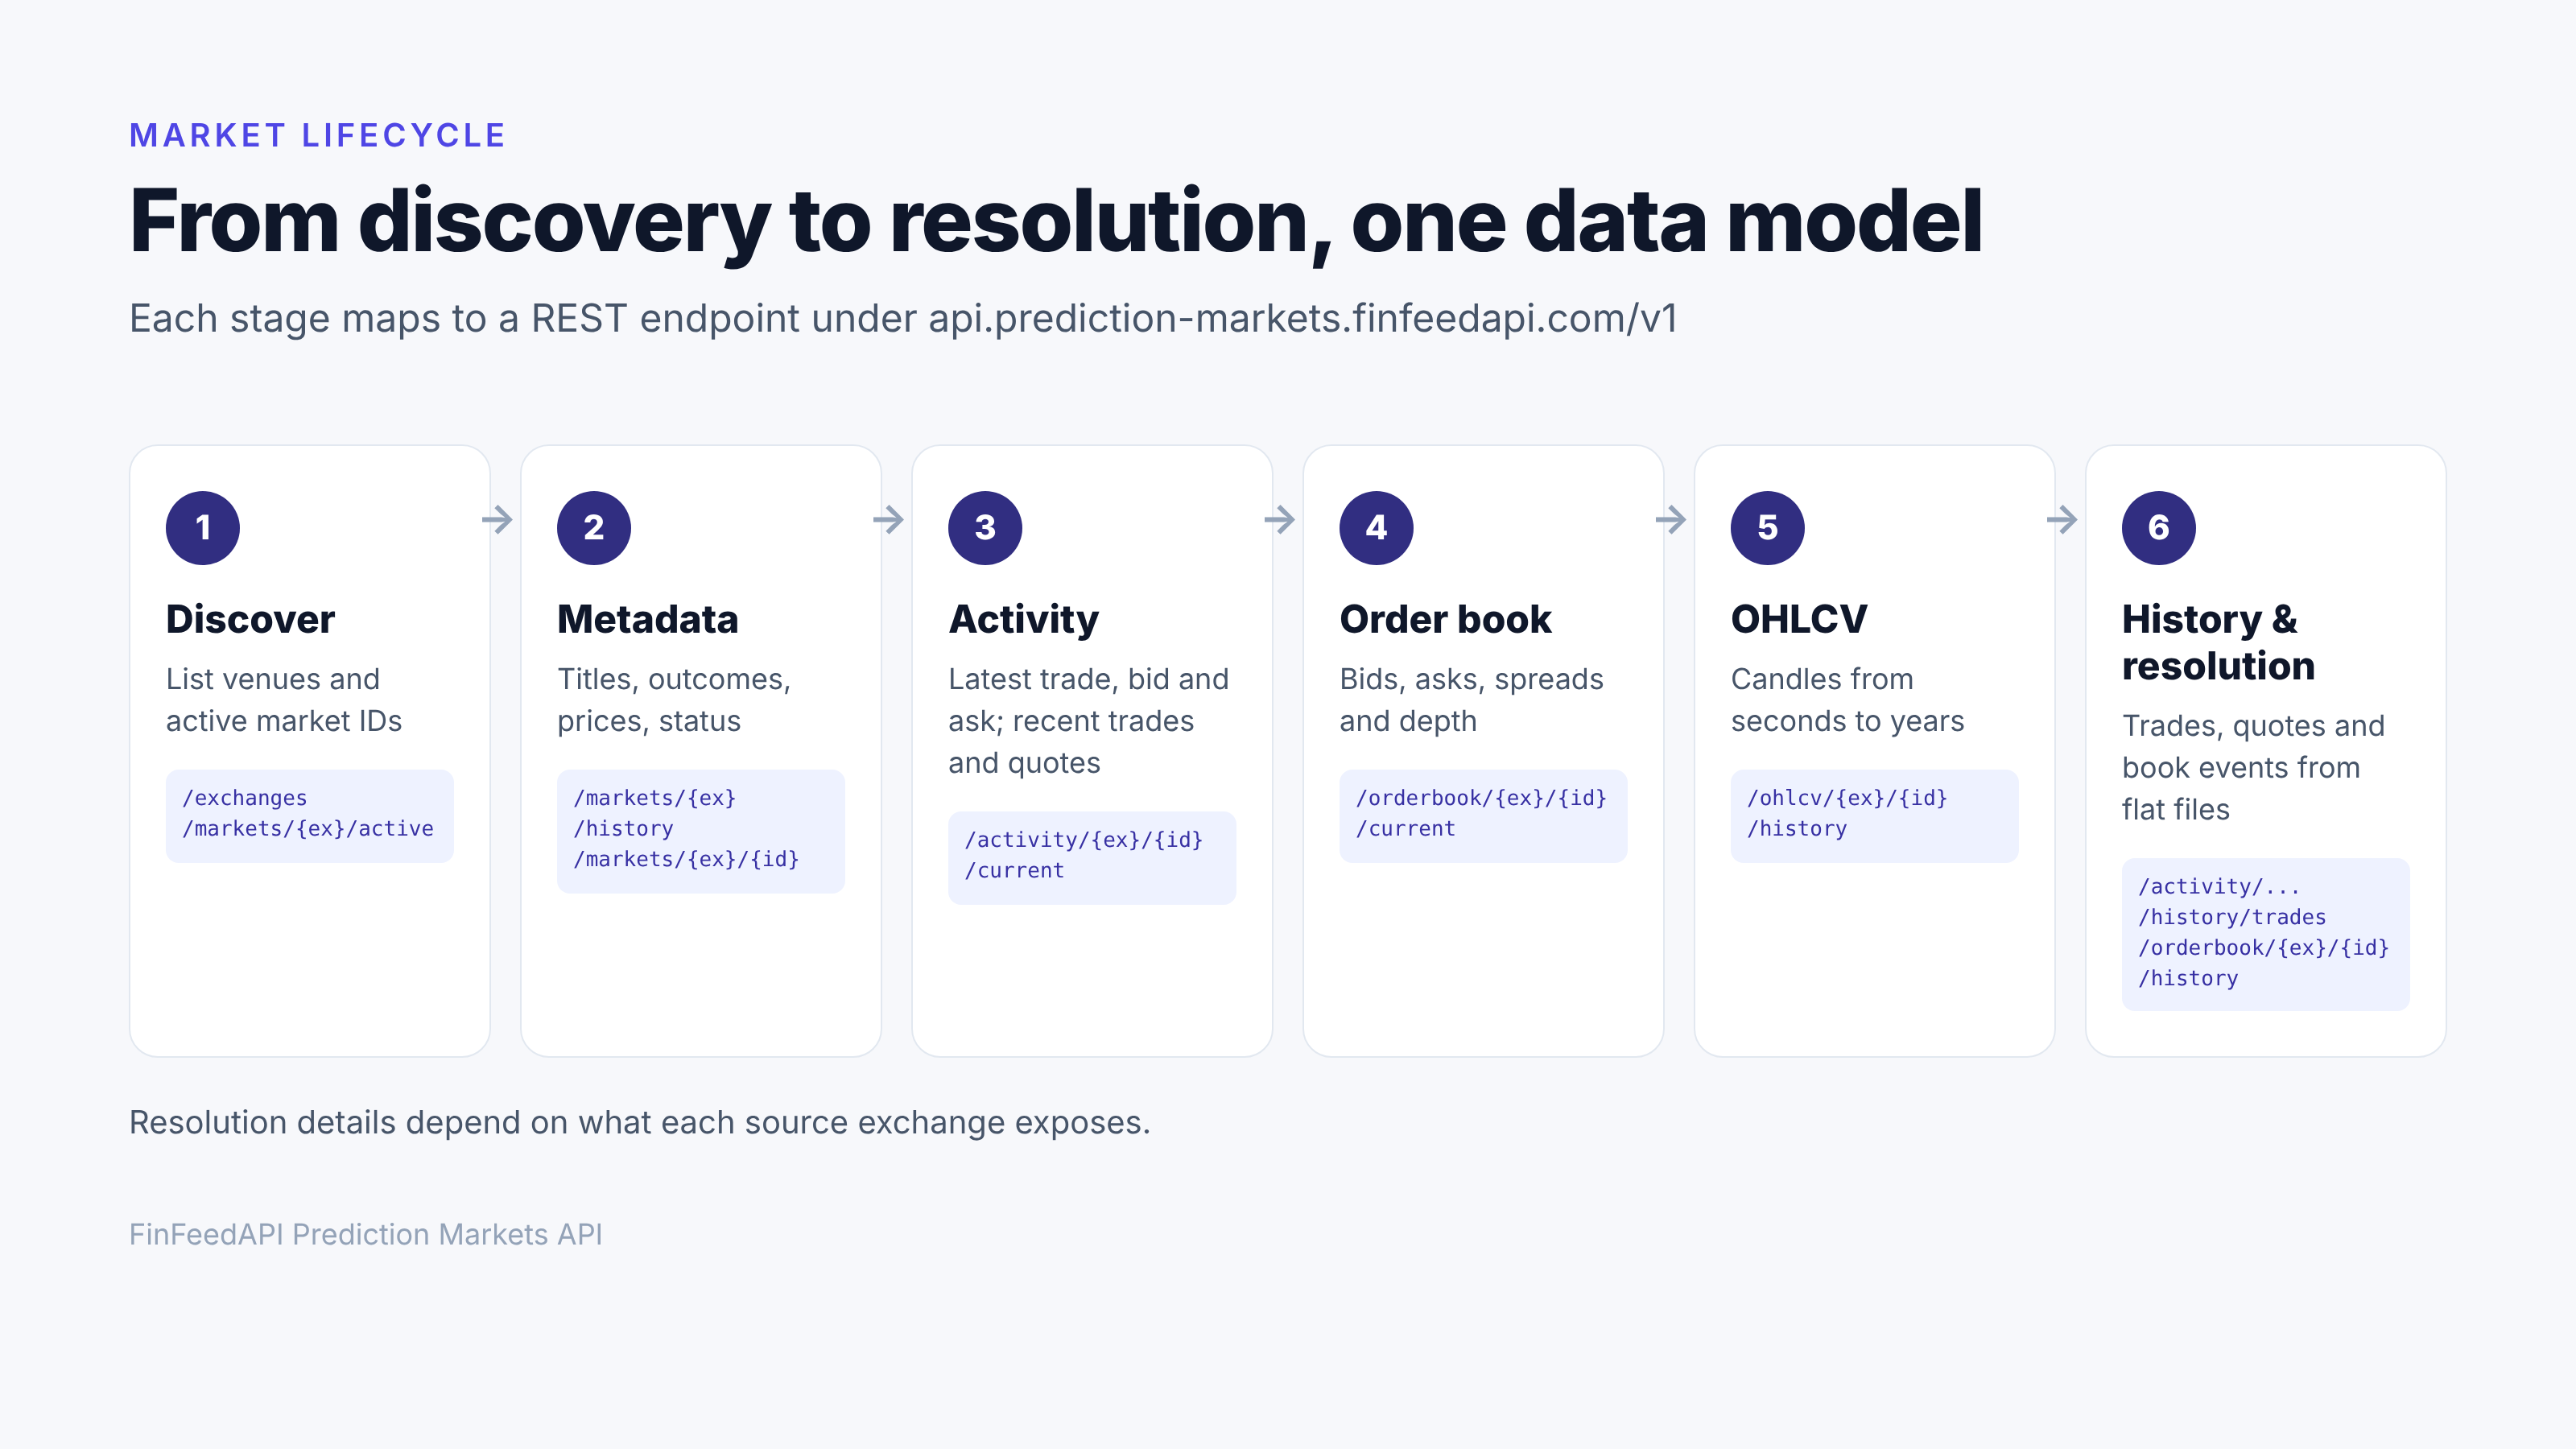
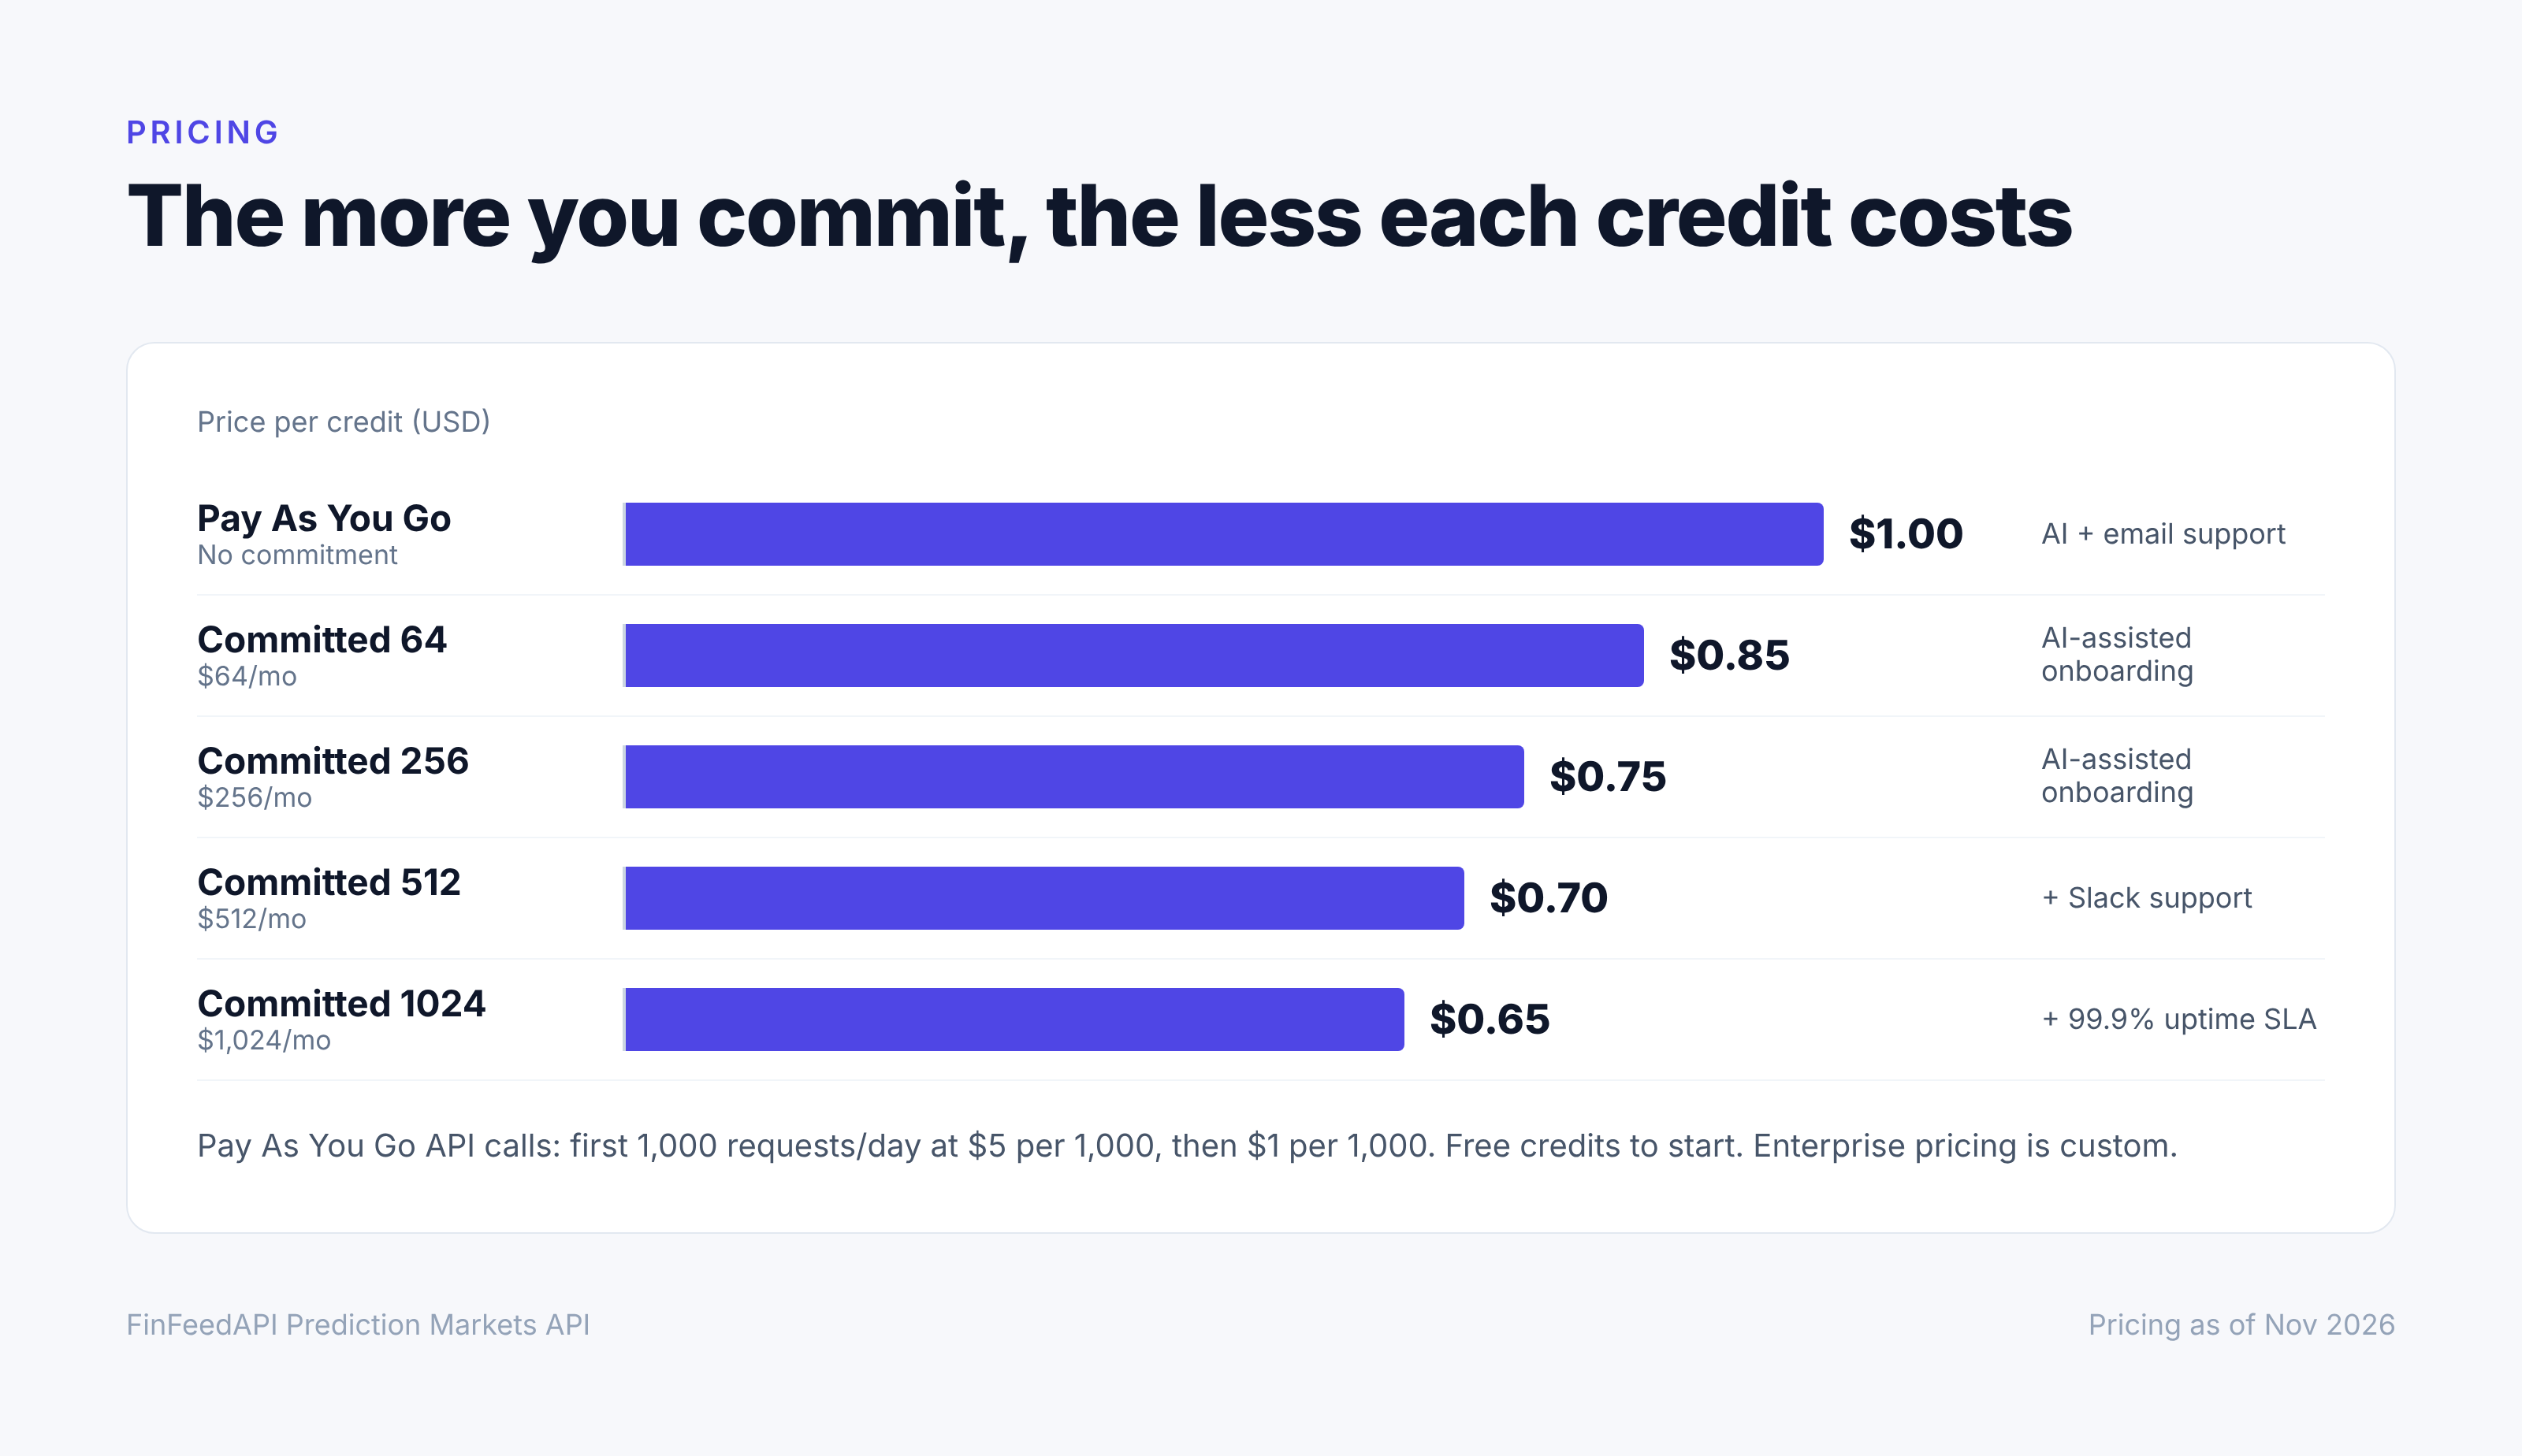
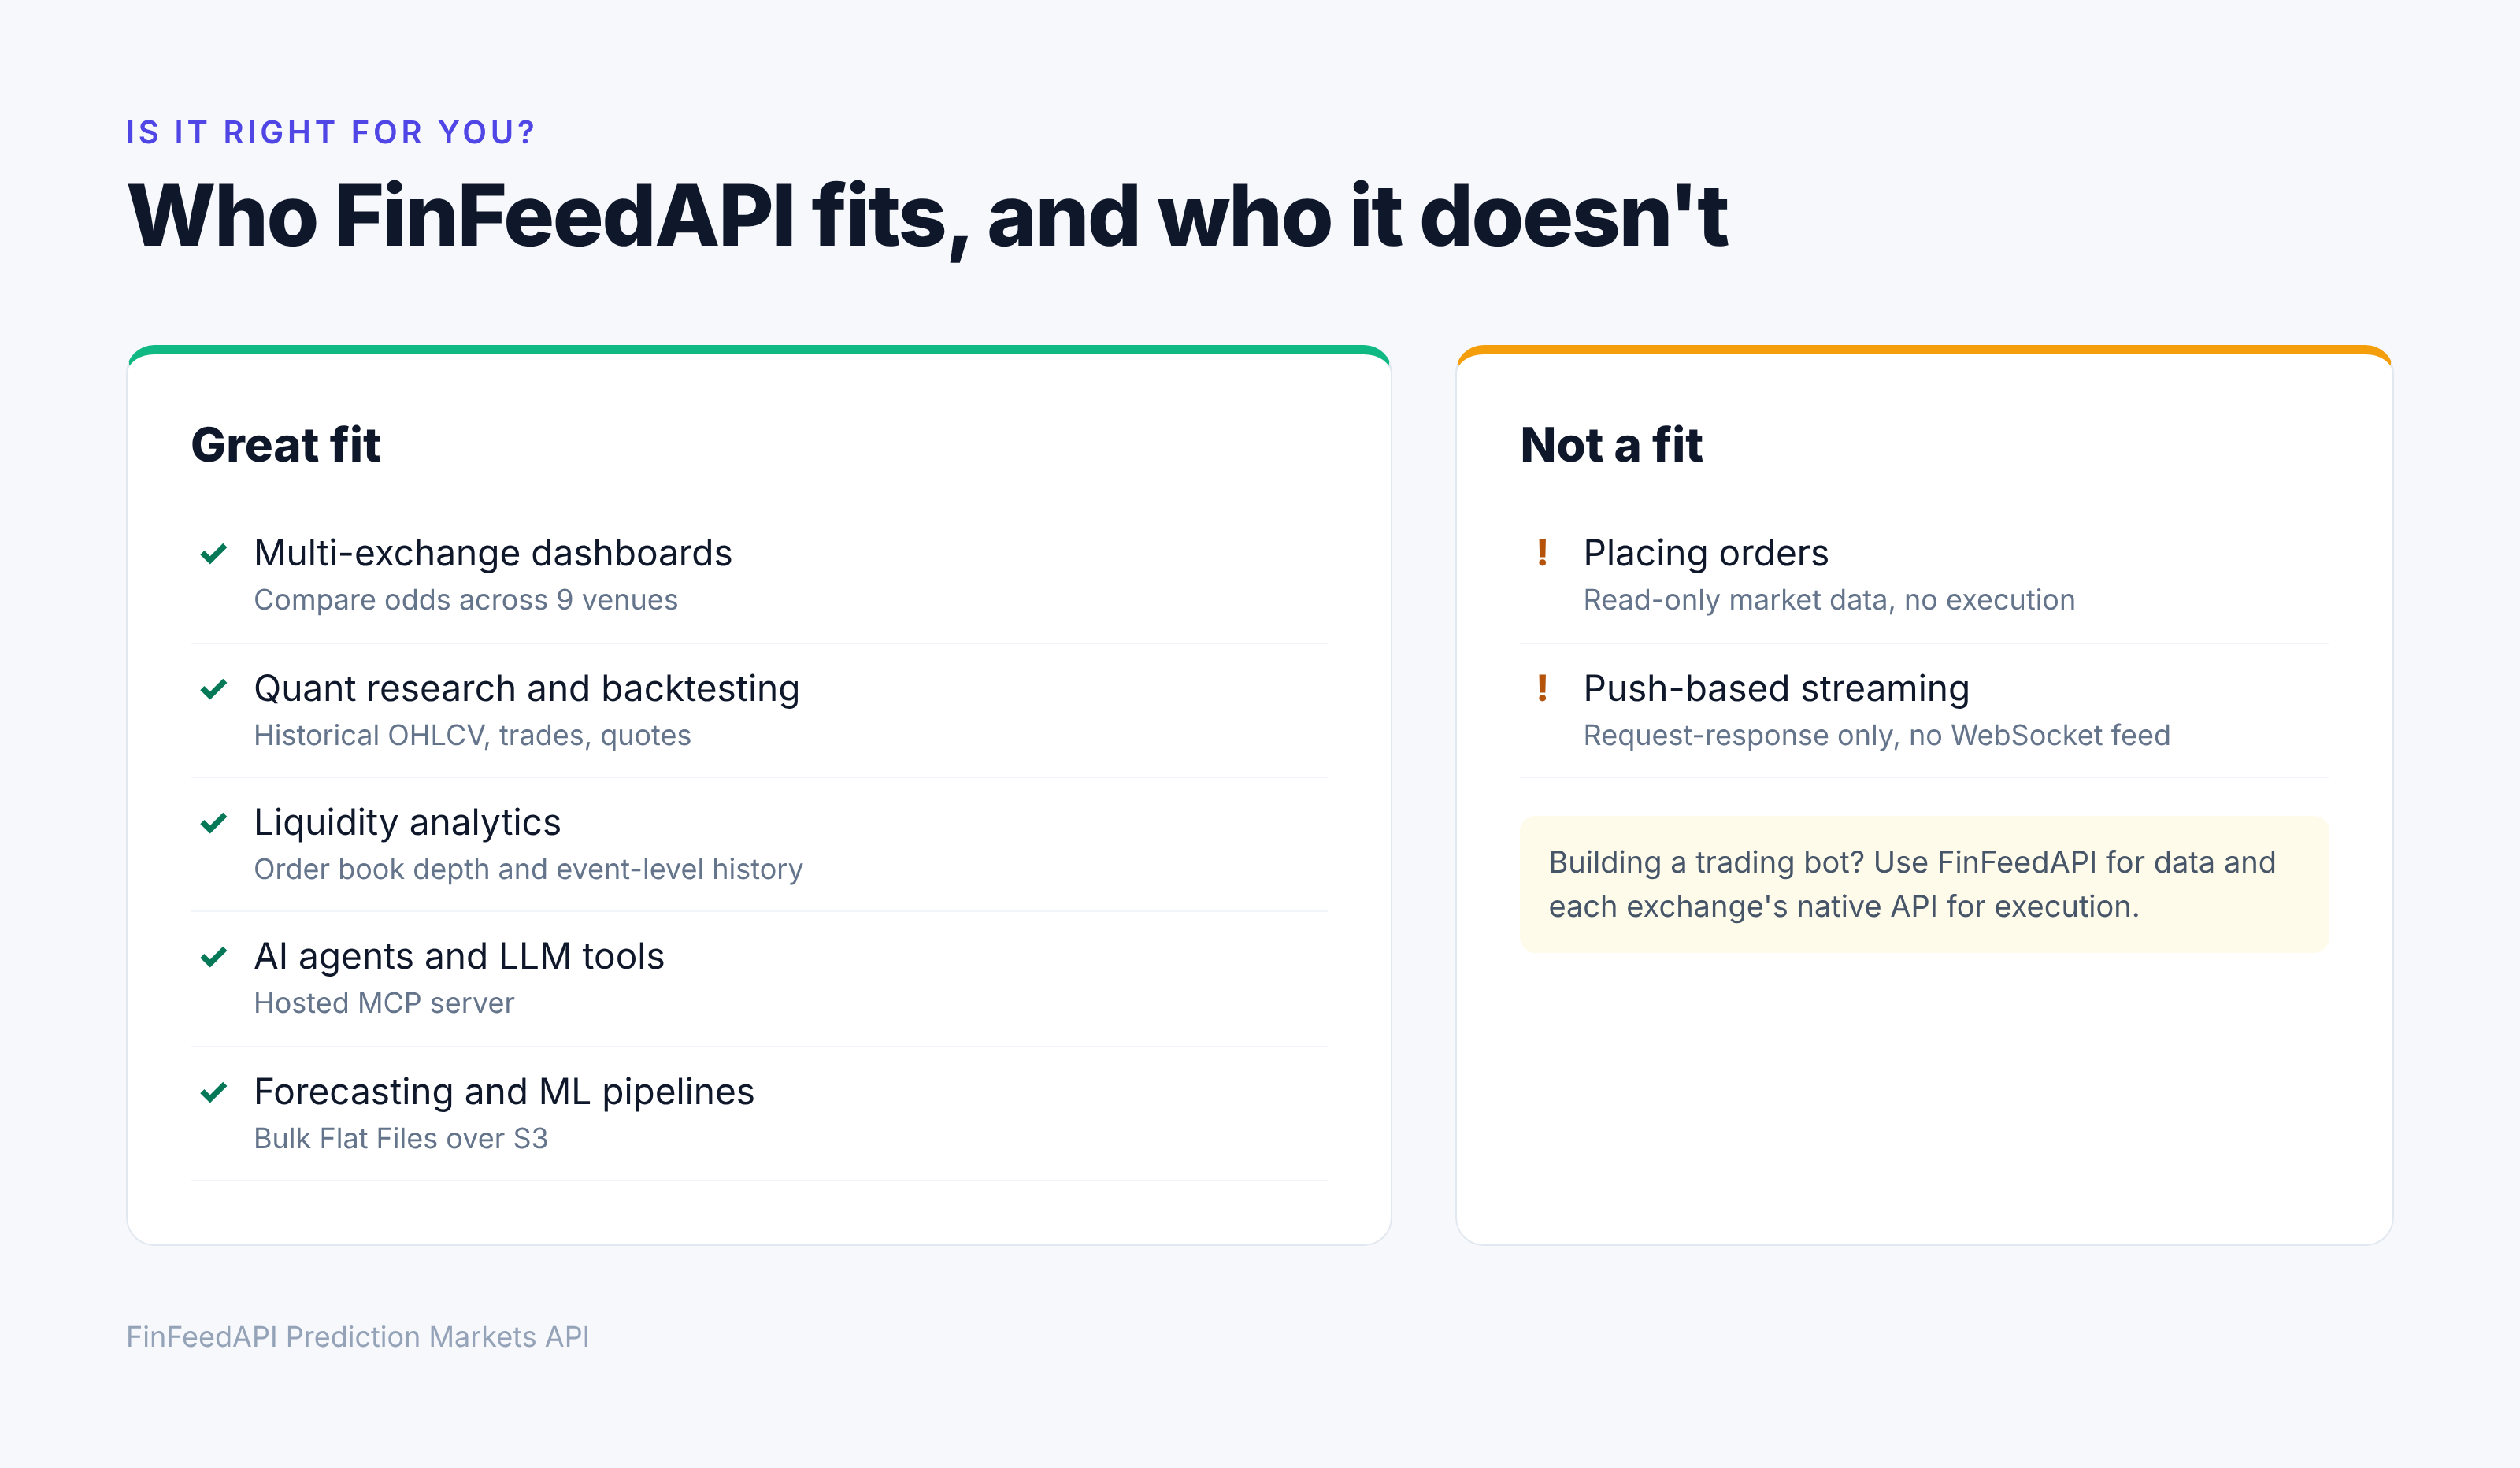
FinFeedAPIレビュー:マルチ取引所の予測市場データAPI Kalshi、Polymarket、ForecastExにまたがる単一の経済イベントを市場がどのように価格付けするかを追跡したいと想像してください。紙の上では、それはシンプルなダッシュボードのように聞こえます。実際には、3つの異なるAPI、同じ市場を識別する3つの方法、そして1つのチャートを描く前に調整しなければならない3つのレスポンス形式を意味します。 {% cta apidog.com %} 今すぐApidogを試す {% endcta %} その問題は新しい会場ごとに大きくなります。予測市場は現在、規制された米国取引所、オンチェーンプロトコル、プレイマネーコミュニティ、確立された暗号通貨プラットフォームからのイベント契約にまで広がっており、それらのいずれも共通のデータモデルを共有していません。 これは FinFeedAPI が埋めるために作られたギャップです。そのPrediction Markets APIは9つの取引所を1つの標準化されたスキーマの下にまとめ、開発者がデータの出所に関係なく、市場、取引、オーダーブック、履歴を同じ方法でクエリできるようにします。 !FinFeedAPI Prediction Markets API 開発者にとって、その成長には厄介な真実が伴います。各会場は独自のAPI、独自の市場識別子、独自の命名規則、そして「市場」がどのようなものであるかについての独自の考え方を公開しています。3つのプラットフォームで同じイベントを追跡するダッシュボードが欲しいですか? そうなると、3つの統合、3つのデータモデル、3つのエッジケースのセットを維持することになります。 まさにそれが FinFeedAPI が解決しようとしている問題です。 このレビューでは、FinFeedAPIのPrediction Markets APIが何をカバーしているか、実際に得られるデータ、エンドポイントが実際にどのように見えるか、コスト、そしてどこが不十分かを説明し、あなたのスタックに合うかどうかを判断できるようにします。 TL;DR | 項目 | 概要 | | --- | --- | | プロバイダー | API BricksによるFinFeedAPI(CoinAPIの背後でもある) | | 対応取引所 | 9つの予測市場会場 | | データ | 市場とメタデータ、取引、クオート、オーダーブック、OHLCV、履歴フラットファイル | | アクセス | REST、JSON-RPC、ホスト型MCPサーバー、フラットファイル(S3) | | モード | 読み取り専用の市場データ、リクエスト・レスポンス(WebSocketストリームなし) | | 価格設定 | 開始時に無料クレジット、その後1,000リクエストあたり$1からの使用量ベース | | 最適な用途 | 取引所間ダッシュボード、リサーチ、バックテスト、AIエージェント | FinFeedAPIとは? !FinFeedAPI FinFeedAPI は、API Bricks によって構築された金融データプロバイダーであり、CoinAPIの背後にある同じ会社です。そのStock、Currencies、SEC APIに加えて、9つの予測市場取引所からの市場データへの標準化されたアクセスを1つの統合を通じて提供する Prediction Markets API を提供しています。 アイデアはシンプルです。9つのAPIを学ぶ代わりに、1つを学びます。市場ID、結果、タイムスタンプ、レスポンス構造は、データがどの取引所から来たかに関係なく、同じスキーマに従います。 ドキュメントを読み進める中で、いくつかのエンジニアリングの詳細が目に留まりました: - 統合データモデル:すべてのサポート対象取引所にわたる - 結果を含む標準化された市場ID、例えば ..._YES や ..._NO - すべてのエンドポイントでのISO 8601 UTCタイムスタンプ - 一貫した数値精度、最大19桁で小数点以下9桁 - 4つのアクセス方法:REST、JSON-RPC、ホスト型MCPサーバー、フラットファイル 最初に明確にしておくべきこと:FinFeedAPIは読み取り専用の市場データレイヤーです。注文を出すことはありません。製品に執行が必要な場合は、その部分について各取引所のネイティブAPIを引き続き使用します。 !FinFeedAPIのデータモデル 対応する予測市場プラットフォーム FinFeedAPIは現在、規制された取引所、分散型プロトコル、オンチェーンの結果市場、プレイマネーコミュニティにまたがる9つの会場をカバーしています。 | プラットフォーム | タイプ | カバー内容 | | --- | --- | --- | | Polymarket | 分散型 | 政治、経済、暗号通貨、スポーツ、およびグローバルイベント | | Kalshi | 規制対象 (CFTC) | 経済指標、選挙、天気、スポーツなどに関する米国イベント契約 | | ForecastEx | 規制対象 (CFTC) | 経済的および金融的結果を含む米国イベント契約 | | Gemini Prediction Markets | 規制対象 | スポーツ、暗号通貨、経済、政治、その他のトピックに関するイベント契約 | | crypto.com Prediction Markets | 規制対象 | crypto.comの予測市場プラットフォーム上のイベントベースの契約 | | Myriad | 分散型 | 暗号通貨、時事問題、その他の結果 | | Pascal | 分散型 | Solana上に構築されたノンカストディアル予測市場 | | Hyperliquid Outcome Markets (HIP-4) | オンチェーン結果市場 | Hyperliquidのネイティブインフラストラクチャ上のバイナリおよびマルチ結果イベント契約 | | Manifold Markets | ソーシャル、プレイマネー | 幅広いトピックに関するコミュニティ主導の市場 | この組み合わせがこれを面白くしています。規制された会場、暗号通貨ネイティブの会場、プレイマネーの群衆が同じイベントをどのように価格付けするかを比較することは、取引所間のリサーチが価値を持つところです。また、正規化されたスキーマが最も時間を節約するところでもあります。 どのようなデータにアクセスできますか? !アクセスできるデータ ここがFinFeedAPIの真価が発揮されるところです。ほとんどの予測市場ツールは最新価格で止まります。FinFeedAPIは、発見からオーダーブックの深さ、履歴に至るまで市場全体を公開します。 すべてのRESTエンドポイントは https://api.prediction-markets.finfeedapi.com/v1 の下にあります。 | データセット | エンドポイント | 取得内容 | | --- | --- | --- | | 取引所 | GET /exchanges と /exchanges/{exchange_id} | サポートされている会場、取引所ID、説明、ウェブサイト | | アクティブ市場 | GET /markets/{exchange_id}/active | 現在アクティブな市場IDのコンパクトなリスト | | 市場リスト | GET /markets/{exchange_id}/history | カーソルベースのページネーションを備えた完全な市場レコード:タイトル、説明、結果、価格、ステータス | | 単一市場 | GET /markets/{exchange_id}/{market_id} | 1つの市場のメタデータ | | 現在のアクティビティ | GET /activity/{exchange_id}/{market_id}/current | 最新の取引と最新の買値と売値 | | 最近のアクティビティ | GET /activity/{exchange_id}/{market_id}/latest | 最近の取引とクオートの更新 | | 履歴取引とクオート | GET /activity/{exchange_id}/{market_id}/history/trades と /history/quotes | フラットファイルから提供される履歴レコード | | 現在のオーダーブック | GET /orderbook/{exchange_id}/{market_id}/current | 市場結果に対する買値と売値 | | 履歴オーダーブック | GET /orderbook/{exchange_id}/{market_id}/history | ブック再構築のための生の指値注文イベント(追加、更新、削除) | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | 始値、高値、安値、終値、出来高、取引回数を含むローソク足 | 知っておくべきいくつかのこと: - 発見は2段階です。 /active エンドポイントはIDのみを返します。これは最近のクオートと取引から導出されるためです。完全な詳細については、/history または単一市場エンドポイントを呼び出します。 - OHLCV期間は秒から年まで実行されます。また、履歴ローソク足は昇順の時間順で返されます。これはバックテストに必要なものです。 - 履歴オーダーブックデータはイベントレベルです。単なるスナップショットではありません。これにより、市場のリプレイと流動性リサーチへの扉が開きます。 - ライフサイクルと解決データは、オープン、クローズ、解決済み、一時停止のステータスをカバーし、ソース取引所がサポートする場合は解決情報を含みます。 はじめに:最初のリクエスト オンボーディングは迅速です。無料アカウントを作成し、コンソールからAPIキーを生成すると、無料クレジットで開始できます。 RESTおよびJSON-RPCの場合、キーを Authorization ヘッダーで渡します。ドキュメントでは、X-APIKey、X-APIBricks-Key、X-CoinAPI-Key も受け入れます。 1. サポートされている取引所をリストする ここから始めて、他のすべての場所で使用する正確な exchange_id 値を取得します。 curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL] 2. アクティブ市場を発見する curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] これは、各市場IDが結果を組み込んだプレーンなリストを返します: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. 最新の取引とクオートを取得する curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL]_KEY" レスポンスは、最新の取引と、その結果に対する最新の買値と売値を提供します。 4. Pythonで履歴OHLCVを取得する これは、確率チャートやバックテストを構築するときに最初に手を伸ばす呼び出しです。 import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) 各ローソク足には time_period_start、time_period_end、price_open、price_high、price_low、price_close、volume_traded、trades_count が含まれます。サポートされているすべての period_id を確認するには、/ohlcv/periods を呼び出します。 5. オーダーブックの深さを確認する curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] スナップショットは exchange_id、market_id、time_exchange、time_coinapi、そして bids と asks 配列を返します。これでスプレッドとトップオブブックの不均衡を計算するのに十分です。 生のHTTPを書きたくない場合、API Bricksは公式SDK(Python、Node.js、Go、C#など)を GitHub SDKリポジトリ で公開しています。 RESTを超えて:MCP、JSON-RPC、フラットファイル すべてのインターフェースは同じ標準化されたデータセットを公開します。アーキテクチャに合ったものを選択します。 | インターフェース | 認証ヘッダー | 最適な用途 | | --- | --- | --- | | REST API | Authorization | ダッシュボード、分析、プロダクションアプリ | | JSON-RPC API | Authorization | 同じデータに対してRPCスタイルの呼び出しを好むサービス | | ホスト型MCPサーバー | X-APIKey | AIアシスタント、コーディングエージェント、リサーチワークフロー | | フラットファイル (S3) | S3互換の認証情報 | バックテストと機械学習のためのバルク履歴 | MCPサーバーは際立っています 私の見解では、これが製品の最も先進的な部分です。エージェントにAPIドキュメントを教える代わりに、ホスト型MCPエンドポイントを指し示すと、エージェント自身がツールを発見します。 セットアップは、Cursor、Claude Desktop、またはMCP対応クライアントでの数行の設定です: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { "X-APIKey": "YOUR_API_KEY_HERE" } } } } サーバーは現在、次のツールを公開しています: - 取引所の発見:exchanges_list、exchanges_get - 市場の発見:markets_get_active、markets_get_history - ライブアクティビティ:activity_get_current、activity_get_latest - 履歴取引とクオート:activity_get_trades_history、activity_get_quotes_history - OHLCV:ohlcv_list_periods、ohlcv_get_latest_market、ohlcv_get_history_market、ohlcv_get_history_exchange - オーダーブック:orderbook_get_current、orderbook_get_history つまり、エージェントに「最もアクティブなKalshi市場を見つけて、今週のオッズがどのように動いたかを示して」と尋ねると、エージェントは発見、アクティビティ、OHLCV呼び出しを独自に連鎖させることができます。 古いFinFeedAPI MCP接続を設定している場合の注意:エンドポイントは /sse から /mcp に移動したため、古い設定を更新する必要があります。 大量の履歴のためのフラットファイル 大規模なリサーチでは、ページネーションされたREST呼び出しを介して何年ものデータを取得するのは遅いです。フラットファイルは、S3互換APIを通じてバルク取引、クオート、オーダーブック、OHLCVを提供するので、既に知っているS3ツールとSDKを使用できます。 価格設定 !価格設定 FinFeedAPIはクレジットベースの 使用量ベースの価格設定 を使用しています。無料クレジットで開始し、その後リクエストごとに支払います。 Pay As You Goでは、1日あたり最初の1,000リクエストは1,000あたり$5、1日あたり1,000を超えると1,000あたり$1に下がります。コミットメントプランはその料金を下げます。 | プラン | 月額 | クレジットあたりの料金 | 注目の追加機能 | | --- | --- | --- | --- | | Pay As You Go | コミットメントなし | $1.00 | AIとメールサポート、セルフサービスオンボーディング | | Committed 64 | $64 | $0.85 | AI支援オンボーディング | | Committed 256 | $256 | $0.75 | AI支援オンボーディング | | Committed 512 | $512 | $0.70 | Slackサポート、専用Slackチャンネル | | Committed 1024 | $1,024 | $0.65 | 99.9%稼働率SLA、カスタマーサクセス担当、ヒューマンオンボーディング | | Enterprise | カスタム | カスタム | カスタムSLA、レイテンシ最適化、専用インフラストラクチャ | コミットメントプランは使用量を減らすものではありません。同じ支出でより多くのクレジットを提供し、それらのクレジットがなくなると、追加使用量はPay As You Go料金で請求されます。年間請求も利用可能です。 私の見解:プロトタイプとリサーチには、Pay As You Goで十分です。数秒ごとに多くの市場をポーリングする場合は、最初に数字を計算してください。FinFeedAPIは、ダッシュボード、オーダーブック監視、OHLCVバックフィルの 価格設定の使用例 を公開しており、見積もりがずっと簡単になります。 FinFeedAPIが不十分な点 完璧なAPIはありませんし、トレードオフを省略したレビューはあまり役に立ちません。心に留めておくべきことは次のとおりです: - 注文執行はありません。 これはデータレイヤーのみです。取引ボットは注文を出すために依然としてネイティブ取引所APIが必要です。 - 予測市場用のWebSocketストリームはありません。 現在のデータはリクエスト・レスポンス呼び出しを通じて提供されるため、「ライブ」とはポーリングを意味します。レイテンシに敏感な戦略にとって、これは実際の制約であり、頻繁なポーリングは請求額を増やします。 - 1日あたり最初の1,000リクエストが最も高価です。 1,000あたり$5対その後1,000あたり$1では、非常に小さなプロジェクトは忙しいプロジェクトよりも高い実効料金を支払います。 - 解決データはソースに依存します。 ライフサイクルと解決の詳細は、各取引所が公開するものと同じくらい完全です。 - 正規化はトレードオフです。 統合スキーマが要点ですが、1つの会場に固有のフィールドに依存する場合は、コミットする前に データサンプル を確認してください。 これらはいずれも、分析、リサーチ、AIのユースケースにとって致命的ではありません。これらが最も重要になるのは、高頻度取引システムを構築している場合です。 誰がFinFeedAPIを使うべきか? 強み - 1つのスキーマの背後にある9つの予測市場会場 - 完全な市場ライフサイクル:発見、取引、クオート、オーダーブック、OHLCV、履歴 - リプレイ用のイベントレベルの履歴オーダーブックデータ - CursorとClaude Desktopで動作するホスト型MCPサーバー - リサーチと機械学習のためのバルクフラットファイル - 無料クレジットで開始できる使用量ベースの価格設定 最適な用途 - 会場間でオッズを比較するマルチ取引所ダッシュボード - 予測市場戦略をバックテストするクオンツリサーチャーとアナリスト - クリーンな履歴OHLCVを必要とする予測とMLチーム - オーダーブックの深さとスプレッドに基づく流動性分析 - 現実世界のイベントについて推論するエージェントを構築するAIチーム - 群衆が結果をどのように価格付けするかに関する学術的および経済的研究 おそらく向かない用途 - 注文を出す必要があるボット - プッシュベースのサブ秒ストリームが必要な戦略 最終的な感想 !最終的な感想 予測市場は、ほとんどのチームが統合できるよりも速く成長しています。新しい会場ごとに、新しい識別子、新しい形式、新しいメンテナンス作業がもたらされます。 FinFeedAPIは取引所になろうとはしていません。1つの仕事に焦点を当てています:9つの断片化された会場を1つの一貫したデータレイヤーに変えることです。市場、取引、クオート、オーダーブック、OHLCV、詳細な履歴はすべて、REST、JSON-RPC、MCP、またはフラットファイルを通じて同じ形で返されます。 読み取り専用でリクエスト・レスポンスであることを理解した上で進めば、予測ダッシュボードからAIリサーチエージェントまで、幅広い製品に適合します。 9つの会場。1つのスキーマ。1つのAPIキー。配管を減らし、構築を増やす。 ウェブサイト: finfeedapi.com APIドキュメント: Prediction Markets REST APIドキュメント
รีวิว FinFeedAPI: API ข้อมูลตลาดคาดการณ์หลาย Exchange !FinFeedAPI Prediction Markets API ลองจินตนาการว่าคุณต้องการติดตามว่าราคาในตลาดของเหตุการณ์ทางเศรษฐกิจหนึ่งเหตุการณ์เป็นอย่างไร across Kalshi, Polymarket และ ForecastEx ในทางทฤษฎี ฟังดูเหมือนแดชบอร์ดง่าย ๆ แต่ในทางปฏิบัติ มันหมายถึง API สามตัวที่ต่างกัน สามวิธีในการระบุตลาดเดียวกัน และรูปแบบการตอบกลับสามแบบที่ต้องมาปรับให้เข้ากันก่อนที่คุณจะวาดกราฟได้สักกราฟ {% cta apidog.com %} ลองใช้ Apidog วันนี้ {% endcta %} ปัญหานี้จะยิ่งโตขึ้นตามทุก ๆ แพลตฟอร์มใหม่ที่เพิ่มเข้ามา ตลาดทำนายผล (prediction markets) ในปัจจุบันครอบคลุมตั้งแต่ตลาดซื้อขายที่อยู่ภายใต้การกำกับดูแลในสหรัฐฯ โปรโตคอลบนเชน ชุมชนที่ใช้เงินเล่น และสัญญาเหตุการณ์จากแพลตฟอร์มคริปโตที่มั่นคง ซึ่งไม่มีเจ้าไหนใช้โมเดลข้อมูลร่วมกันเลย นี่คือช่องว่างที่ FinFeedAPI ถูกสร้างขึ้นมาเพื่ออุดให้เต็ม Prediction Markets API ของมันรวบรวมตลาดซื้อขายเก้าแห่งไว้ภายใต้สคีมาเดียวที่เป็นมาตรฐาน ทำให้นักพัฒนาสามารถสอบถามข้อมูลตลาด ธุรกรรม สมุดคำสั่งซื้อ และข้อมูลย้อนหลังได้ในวิธีเดียวกัน ไม่ว่าข้อมูลจะมาจากที่ใดก็ตาม !assets.apidog.com สำหรับนักพัฒนาแล้ว การเติบโตนี้มาพร้อมกับความจริงที่ยุ่งเหยิง ทุกแพลตฟอร์มเปิดเผย API ของตัวเอง ตัวระบุตลาดของตัวเอง ธรรมเนียมการตั้งชื่อของตัวเอง และนิยามของคำว่า "ตลาด" ของตัวเอง อยากได้แดชบอร์ดที่ติดตามเหตุการณ์เดียวกันข้ามสามแพลตฟอร์มใช่ไหม? ตอนนี้คุณต้องดูแลอินทิเกรชันสามชุด โมเดลข้อมูลสามชุด และชุดกรณีขอบ (edge case) สามชุด นั่นคือปัญหาที่ FinFeedAPI กำลังพยายามแก้ ในรีวิวนี้ ผมจะพาคุณดูว่า Prediction Markets API ของ FinFeedAPI ครอบคลุมอะไรบ้าง คุณจะได้ข้อมูลอะไรจริง ๆ endpoint ต่าง ๆ หน้าตาเป็นอย่างไรในทางปฏิบัติ ค่าใช้จ่ายเท่าไร และจุดที่ยังทำได้ไม่ดีอยู่ตรงไหน เพื่อให้คุณตัดสินใจได้ว่ามันเข้ากับสแต็กของคุณหรือไม่ สรุปสั้น ๆ | | | | --- | --- | | ผู้ให้บริการ | FinFeedAPI โดย API Bricks (บริษัทเดียวกับที่อยู่เบื้องหลัง CoinAPI) | | ตลาดซื้อขายที่ครอบคลุม | แพลตฟอร์มตลาดทำนายผล 9 แห่ง | | ข้อมูล | ตลาดและเมทาดาทา ธุรกรรม ราคาเสนอ สมุดคำสั่งซื้อ OHLCV ไฟล์แบนข้อมูลย้อนหลัง | | การเข้าถึง | REST, JSON-RPC, เซิร์ฟเวอร์ MCP แบบโฮสต์, Flat Files (S3) | | โหมด | ข้อมูลตลาดแบบอ่านอย่างเดียว, แบบคำขอ-ตอบกลับ (ไม่มีสตรีม WebSocket) | | ราคา | เริ่มต้นด้วยเครดิตฟรี จากนั้นคิดตามการใช้งานเริ่มที่ $1 ต่อ 1,000 คำขอ | | เหมาะที่สุดสำหรับ | แดชบอร์ดข้ามตลาดซื้อขาย งานวิจัย การทดสอบย้อนหลัง เอเจนต์ AI | FinFeedAPI คืออะไร? !image.png FinFeedAPI เป็นผู้ให้บริการข้อมูลทางการเงินที่สร้างโดย API Bricks ซึ่งเป็นบริษัทเดียวกับที่อยู่เบื้องหลัง CoinAPI นอกเหนือจาก API ด้านหุ้น สกุลเงิน และ SEC แล้ว ยังมี Prediction Markets API ที่ให้คุณเข้าถึงข้อมูลตลาดจากแพลตฟอร์มตลาดทำนายผลเก้าแห่งผ่านการอินทิเกรตเพียงครั้งเดียวอย่างเป็นมาตรฐาน แนวคิดนั้นเรียบง่าย: แทนที่จะต้องเรียนรู้ API เก้าตัว คุณเรียนรู้แค่ตัวเดียว ตัวระบุตลาด ผลลัพธ์ timestamp และโครงสร้างการตอบกลับเป็นไปตามสคีมาเดียวกัน ไม่ว่าข้อมูลจะมาจากตลาดซื้อขายใดก็ตาม มีรายละเอียดทางวิศวกรรมบางอย่างที่โดดเด่นสำหรับผมขณะอ่านเอกสาร: - โมเดลข้อมูลแบบรวม ครอบคลุมทุกตลาดซื้อขายที่รองรับ - ตัวระบุตลาดที่เป็นมาตรฐาน ซึ่งรวมผลลัพธ์ไว้ด้วย เช่น ..._YES และ ..._NO - timestamp แบบ ISO 8601 UTC ในทุก endpoint - ความแม่นยำเชิงตัวเลขที่สม่ำเสมอ สูงสุด 19 หลัก ทศนิยม 9 ตำแหน่ง - ช่องทางเข้า 4 แบบ: REST, JSON-RPC, เซิร์ฟเวอร์ MCP แบบโฮสต์ และ Flat Files มีสิ่งหนึ่งที่ควรทำให้ชัดตั้งแต่ต้น: FinFeedAPI เป็น ชั้นข้อมูลตลาดแบบอ่านอย่างเดียว มันไม่ได้ส่งคำสั่งซื้อ ถ้าผลิตภัณฑ์ของคุณต้องการส่งคำสั่งซื้อจริง คุณก็ยังต้องใช้ API ดั้งเดิมของแต่ละตลาดซื้อขายสำหรับส่วนนั้น !assets.apidog.com แพลตฟอร์มตลาดทำนายผลที่รองรับ ปัจจุบัน FinFeedAPI ครอบคลุมเก้าแพลตฟอร์ม ตั้งแต่ตลาดซื้อขายที่อยู่ภายใต้การกำกับดูแล โปรโตคอลแบบกระจายศูนย์ ตลาดผลลัพธ์บนเชน ไปจนถึงชุมชนที่ใช้เงินเล่น | แพลตฟอร์ม | ประเภท | สิ่งที่ครอบคลุม | | --- | --- | --- | | Polymarket | กระจายศูนย์ | การเมือง เศรษฐกิจ คริปโต กีฬา และเหตุการณ์ระดับโลก | | Kalshi | อยู่ภายใต้การกำกับดูแล (CFTC) | สัญญาเหตุการณ์ในสหรัฐฯ เกี่ยวกับตัวชี้วัดเศรษฐกิจ การเลือกตั้ง สภาพอากาศ กีฬา และอื่น ๆ | | ForecastEx | อยู่ภายใต้การกำกับดูแล (CFTC) | สัญญาเหตุการณ์ในสหรัฐฯ รวมถึงผลลัพธ์ทางเศรษฐกิจและการเงิน | | Gemini Prediction Markets | อยู่ภายใต้การกำกับดูแล | สัญญาเหตุการณ์เกี่ยวกับกีฬา คริปโต เศรษฐกิจ การเมือง และหัวข้ออื่น ๆ | | crypto.com Prediction Markets | อยู่ภายใต้การกำกับดูแล | สัญญาที่อิงเหตุการณ์บนแพลตฟอร์มตลาดทำนายผลของ crypto.com | | Myriad | กระจายศูนย์ | คริปโต เหตุการณ์ปัจจุบัน และผลลัพธ์อื่น ๆ | | Pascal | กระจายศูนย์ | ตลาดทำนายผลแบบไม่รับฝากทรัพย์สินที่สร้างบน Solana | | Hyperliquid Outcome Markets (HIP-4) | ตลาดผลลัพธ์บนเชน | สัญญาเหตุการณ์แบบสองผลลัพธ์และหลายผลลัพธ์บนโครงสร้างพื้นฐานดั้งเดิมของ Hyperliquid | | Manifold Markets | สังคม, ใช้เงินเล่น | ตลาดที่ขับเคลื่อนโดยชุมชนในหัวข้อที่หลากหลาย | การผสมผสานนี้เองที่ทำให้มันน่าสนใจ การเปรียบเทียบว่าตลาดที่อยู่ภายใต้การกำกับดูแล ตลาดที่เป็นคริปโตโดยกำเนิด และฝูงชนที่ใช้เงินเล่น ตั้งราคาเหตุการณ์เดียวกันอย่างไร คือจุดที่งานวิจัยข้ามตลาดซื้อขายมีคุณค่า และยังเป็นจุดที่สคีมาที่ถูกทำให้เป็นมาตรฐานช่วยประหยัดเวลามากที่สุดด้วย คุณเข้าถึงข้อมูลอะไรได้บ้าง? !assets.apidog.com นี่คือจุดที่ FinFeedAPI คุ้มค่ากับที่ลงทุนไป เครื่องมือตลาดทำนายผลส่วนใหญ่หยุดอยู่แค่ราคาล่าสุด แต่ FinFeedAPI เปิดเผย ทั้งตลาด ตั้งแต่การค้นหาตลาด ไปจนถึงความลึกของสมุดคำสั่งซื้อและข้อมูลย้อนหลัง endpoint ของ REST ทั้งหมดอยู่ภายใต้ https://api.prediction-markets.finfeedapi.com/v1 | ชุดข้อมูล | Endpoint | สิ่งที่คุณได้รับ | | --- | --- | --- | | ตลาดซื้อขาย | GET /exchanges และ /exchanges/{exchange_id} | แพลตฟอร์มที่รองรับ, exchange ID, คำอธิบาย, เว็บไซต์ | | ตลาดที่ยังใช้งานอยู่ | GET /markets/{exchange_id}/active | รายการกระชับของ market ID ที่ยังใช้งานอยู่ในปัจจุบัน | | รายการตลาด | GET /markets/{exchange_id}/history | บันทึกตลาดแบบเต็มพร้อมการแบ่งหน้าด้วยเคอร์เซอร์: ชื่อ คำอธิบาย ผลลัพธ์ ราคา สถานะ | | ตลาดเดี่ยว | GET /markets/{exchange_id}/{market_id} | เมทาดาทาของตลาดหนึ่งแห่ง | | กิจกรรมปัจจุบัน | GET /activity/{exchange_id}/{market_id}/current | ธุรกรรมล่าสุดพร้อมราคาเสนอซื้อและเสนอขายล่าสุด | | กิจกรรมล่าสุด | GET /activity/{exchange_id}/{market_id}/latest | ธุรกรรมและอัปเดตราคาเสนอในช่วงล่าสุด | | ธุรกรรมและราคาเสนอในอดีต | GET /activity/{exchange_id}/{market_id}/history/trades และ /history/quotes | บันทึกย้อนหลังที่ให้บริการจากไฟล์แบน | | สมุดคำสั่งซื้อปัจจุบัน | GET /orderbook/{exchange_id}/{market_id}/current | คำสั่งซื้อและคำสั่งขายสำหรับผลลัพธ์หนึ่งของตลาด | | สมุดคำสั่งซื้อในอดีต | GET /orderbook/{exchange_id}/{market_id}/history | เหตุการณ์คำสั่งซื้อแบบลิมิตดิบ (เพิ่ม อัปเดต ลบ) สำหรับการสร้างสมุดคำสั่งซื้อขึ้นใหม่ | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | แท่งเทียนที่มีราคาเปิด สูง ต่ำ ปิด ปริมาณ และจำนวนธุรกรรม | มีบางอย่างที่ควรรู้: - การค้นหาตลาดเป็นสองขั้นตอน endpoint /active คืนค่าเฉพาะ ID เท่านั้น เพราะมันได้มาจากราคาเสนอและธุรกรรมล่าสุด คุณต้องเรียก /history หรือ endpoint ของตลาดเดี่ยวเพื่อดูรายละเอียดแบบเต็ม - ช่วงเวลาของ OHLCV ตั้งแต่ระดับวินาทีไปจนถึงระดับปี และแท่งเทียนย้อนหลังจะเรียงตามเวลาจากน้อยไปมาก ซึ่งเป็นสิ่งที่คุณต้องการสำหรับการทดสอบย้อนหลัง - ข้อมูลสมุดคำสั่งซื้อในอดีตเป็นระดับเหตุการณ์ ไม่ใช่แค่ภาพรวม ณ ขณะหนึ่ง ซึ่งเปิดทางให้ทำการเล่นซ้ำตลาดและวิจัยสภาพคล่องได้ - ข้อมูลวงจรชีวิตและการตัดสินผล ครอบคลุมสถานะเปิด ปิด ตัดสินผลแล้ว และระงับไว้ พร้อมข้อมูลการตัดสินผลในกรณีที่ตลาดซื้อขายต้นทางรองรับ เริ่มต้นใช้งาน: คำขอแรกของคุณ การเริ่มต้นทำได้รวดเร็ว คุณสร้างบัญชีฟรี สร้าง API key จากคอนโซล และเริ่มต้นด้วยเครดิตฟรี สำหรับ REST และ JSON-RPC คุณส่งคีย์ผ่านเฮดเดอร์ Authorization เอกสารยังรองรับ X-APIKey, X-APIBricks-Key และ X-CoinAPI-Key ด้วย 1. แสดงรายการตลาดซื้อขายที่รองรับ เริ่มจากตรงนี้เพื่อดูค่า exchange_id ที่แน่นอน ซึ่งคุณจะใช้ในทุกที่ต่อไป curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "Authorization: YOUR_API_KEY" 2. ค้นหาตลาดที่ยังใช้งานอยู่ curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] คำสั่งนี้จะคืนค่ารายการ market ID ธรรมดา โดยแต่ละอันมีผลลัพธ์ฝังอยู่ในชื่อ: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. ดึงธุรกรรมและราคาเสนอล่าสุด curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] การตอบกลับจะให้ธุรกรรมล่าสุดพร้อมกับราคาเสนอซื้อและราคาเสนอขายล่าสุดสำหรับผลลัพธ์นั้น 4. ดึงข้อมูล OHLCV ย้อนหลังด้วย Python นี่คือคำสั่งแรกที่ผมจะเลือกใช้เมื่อสร้างกราฟความน่าจะเป็นหรือการทดสอบย้อนหลัง import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) แท่งเทียนแต่ละแท่งประกอบด้วย time_period_start, time_period_end, price_open, price_high, price_low, price_close, volume_traded และ trades_count เรียก /ohlcv/periods เพื่อดู period_id ทั้งหมดที่รองรับ 5. ตรวจสอบความลึกของสมุดคำสั่งซื้อ curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] ภาพรวม ณ ขณะหนึ่งจะคืนค่า exchange_id, market_id, time_exchange, time_coinapi พร้อมอาร์เรย์ bids และ asks เท่านี้ก็เพียงพอสำหรับคำนวณสเปรดและความไม่สมดุลของคำสั่งซื้อที่หัวสมุด ถ้าคุณไม่อยากเขียน HTTP ดิบ ๆ เอง API Bricks มี SDK อย่างเป็นทางการ (Python, Node.js, Go, C# และอื่น ๆ) อยู่ใน รีโป SDK บน GitHub นอกเหนือจาก REST: MCP, JSON-RPC และ Flat Files ทุกอินเทอร์เฟซเปิดเผยชุดข้อมูลมาตรฐานเดียวกัน คุณเลือกอันที่เข้ากับสถาปัตยกรรมของคุณ | อินเทอร์เฟซ | เฮดเดอร์ยืนยันตัวตน | เหมาะที่สุดสำหรับ | | --- | --- | --- | | REST API | Authorization | แดชบอร์ด การวิเคราะห์ แอปพลิเคชันในโปรดักชัน | | JSON-RPC API | Authorization | บริการที่ชอบเรียกแบบ RPC มากกว่าสำหรับข้อมูลชุดเดียวกัน | | เซิร์ฟเวอร์ MCP แบบโฮสต์ | X-APIKey | ผู้ช่วย AI เอเจนต์เขียนโค้ด เวิร์กโฟลว์งานวิจัย | | Flat Files (S3) | ข้อมูลรับรองที่เข้ากันได้กับ S3 | ประวัติข้อมูลจำนวนมากสำหรับการทดสอบย้อนหลังและการเรียนรู้ของเครื่อง | เซิร์ฟเวอร์ MCP คือจุดที่โดดเด่นที่สุด จากมุมมองของผม นี่คือส่วนที่มองไปข้างหน้ามากที่สุดของผลิตภัณฑ์ แทนที่จะต้องสอนเอกสาร API ให้กับเอเจนต์ คุณแค่ชี้มันไปที่ endpoint MCP แบบโฮสต์ แล้วมันจะค้นหาเครื่องมือต่าง ๆ ได้เอง การตั้งค่าใช้โค้ดคอนฟิกไม่กี่บรรทัดใน Cursor, Claude Desktop หรือไคลเอนต์ที่รองรับ MCP ใดก็ตาม: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { [REDACTED CREDENTIAL] } } } } ปัจจุบันเซิร์ฟเวอร์เปิดเผยเครื่องมือสำหรับ: - การค้นหาตลาดซื้อขาย: exchanges_list, exchanges_get - การค้นหาตลาด: markets_get_active, markets_get_history - กิจกรรมสด: activity_get_current, activity_get_latest - ธุรกรรมและราคาเสนอในอดีต: activity_get_trades_history, activity_get_quotes_history - OHLCV: ohlcv_list_periods, ohlcv_get_latest_market, ohlcv_get_history_market, ohlcv_get_history_exchange - สมุดคำสั่งซื้อ: orderbook_get_current, orderbook_get_history นั่นหมายความว่าคุณสามารถถามเอเจนต์ได้ประมาณว่า "หาตลาด Kalshi ที่คึกคักที่สุด แล้วแสดงให้ดูว่าอัตราต่อรองของมันขยับอย่างไรในสัปดาห์นี้" แล้วมันก็จะเชื่อมโยงการเรียกค้นหา กิจกรรม และ OHLCV ต่อกันได้เอง หมายเหตุหนึ่งถ้าคุณตั้งค่าการเชื่อมต่อ MCP ของ FinFeedAPI แบบเก่า: endpoint ย้ายจาก /sse ไปเป็น /mcp ดังนั้นคอนฟิกเก่าจำเป็นต้องอัปเดต Flat Files สำหรับประวัติข้อมูลปริมาณมาก สำหรับงานวิจัยขนาดใหญ่ การดึงข้อมูลหลายปีผ่านการเรียก REST แบบแบ่งหน้าจะช้า Flat Files ให้คุณดึงธุรกรรม ราคาเสนอ สมุดคำสั่งซื้อ และ OHLCV แบบจำนวนมากผ่าน API ที่เข้ากันได้กับ S3 คุณจึงใช้เครื่องมือและ SDK ของ S3 ที่คุณคุ้นเคยอยู่แล้วได้ ราคา !assets.apidog.com FinFeedAPI ใช้ การคิดราคาตามการใช้งาน โดยใช้เครดิตเป็นฐาน คุณเริ่มต้นด้วยเครดิตฟรี จากนั้นจ่ายตามจำนวนคำขอ ในแบบ Pay As You Go 1,000 คำขอแรกต่อวันคิดที่ $5 ต่อ 1,000 คำขอ และส่วนที่เกิน 1,000 ต่อวันจะลดลงเหลือ $1 ต่อ 1,000 คำขอ แพ็กเกจแบบผูกมัดจะลดอัตรานั้นลงอีก | แพ็กเกจ | รายเดือน | อัตราต่อเครดิต | สิทธิประโยชน์เพิ่มเติมที่น่าสนใจ | | --- | --- | --- | --- | | Pay As You Go | ไม่มีข้อผูกมัด | $1.00 | การสนับสนุนทาง AI และอีเมล, การเริ่มต้นใช้งานแบบบริการตนเอง | | Committed 64 | $64 | $0.85 | การเริ่มต้นใช้งานโดยผู้ช่วย AI | | Committed 256 | $256 | $0.75 | การเริ่มต้นใช้งานโดยผู้ช่วย AI | | Committed 512 | $512 | $0.70 | การสนับสนุนผ่าน Slack, ช่อง Slack เฉพาะ | | Committed 1024 | $1,024 | $0.65 | SLA ความพร้อมใช้งาน 99.9%, ผู้ดูแลความสำเร็จของลูกค้า, การเริ่มต้นใช้งานโดยทีมงานจริง | | Enterprise | กำหนดเอง | กำหนดเอง | SLA แบบกำหนดเอง, การปรับแต่งความหน่วง, โครงสร้างพื้นฐานเฉพาะ | แพ็กเกจแบบผูกมัดไม่ได้ลดปริมาณที่คุณใช้ แต่ให้เครดิตคุณมากขึ้นด้วยค่าใช้จ่ายเท่าเดิม และเมื่อเครดิตเหล่านั้นหมด การใช้งานส่วนเกินจะคิดในอัตราแบบ Pay As You Go นอกจากนี้ยังมีตัวเลือกคิดค่าบริการรายปีด้วย ความเห็นของผม: สำหรับต้นแบบและงานวิจัย Pay As You Go ก็เพียงพอ ถ้าคุณต้องโพลข้อมูลตลาดหลายแห่งทุกไม่กี่วินาที ควรคำนวณตัวเลขดูก่อน FinFeedAPI เผยแพร่ กรณีการใช้งานด้านราคา สำหรับแดชบอร์ด การเฝ้าติดตามสมุดคำสั่งซื้อ และการเติมข้อมูล OHLCV ย้อนหลัง ซึ่งช่วยให้ประเมินได้ง่ายขึ้นมาก จุดที่ FinFeedAPI ยังทำได้ไม่ดี ไม่มี API ไหนสมบูรณ์แบบ และรีวิวที่ข้ามข้อแลกเปลี่ยนไปก็ไม่มีประโยชน์อะไร นี่คือสิ่งที่ควรคำนึงถึง: - ไม่มีการส่งคำสั่งซื้อ มันเป็นแค่ชั้นข้อมูล บอทเทรดยังต้องใช้ API ดั้งเดิมของตลาดซื้อขายเพื่อส่งคำสั่งซื้อ - ไม่มีสตรีม WebSocket สำหรับตลาดทำนายผล ข้อมูลปัจจุบันมาจากการเรียกแบบคำขอ-ตอบกลับ ดังนั้นคำว่า "สด" จึงหมายถึงการโพล สำหรับกลยุทธ์ที่ไวต่อความหน่วง นี่เป็นข้อจำกัดจริง และการโพลบ่อย ๆ ก็เพิ่มค่าใช้จ่ายของคุณด้วย - 1,000 คำขอแรกต่อวันมีราคาแพงที่สุด ที่ $5 ต่อ 1,000 คำขอ เทียบกับ $1 ต่อ 1,000 คำขอหลังจากนั้น โปรเจกต์เล็กมาก ๆ จึงจ่ายอัตราที่มีประสิทธิผลสูงกว่าโปรเจกต์ที่ใช้งานหนัก - ข้อมูลการตัดสินผลขึ้นอยู่กับแหล่งข้อมูล รายละเอียดวงจรชีวิตและการตัดสินผลจะครบถ้วนเท่ากับที่แต่ละตลาดซื้อขายเปิดเผยเท่านั้น - การทำให้เป็นมาตรฐานเป็นข้อแลกเปลี่ยน สคีมาแบบรวมคือจุดสำคัญทั้งหมด แต่ถ้าคุณต้องพึ่งพาฟิลด์ที่เป็นเอกลักษณ์ของแพลตฟอร์มใดแพลตฟอร์มหนึ่ง ควรตรวจ ตัวอย่างข้อมูล ก่อนตัดสินใจ ไม่มีข้อใดในนี้ที่เป็นตัวตัดสินให้เลิกใช้สำหรับกรณีการใช้งานด้านการวิเคราะห์ งานวิจัย หรือ AI มันจะสำคัญที่สุดก็ต่อเมื่อคุณกำลังสร้างระบบเทรดความถี่สูง ใครควรใช้ FinFeedAPI? จุดแข็ง - แพลตฟอร์มตลาดทำนายผลเก้าแห่งภายใต้สคีมาเดียว - วงจรชีวิตตลาดแบบครบถ้วน: การค้นหา ธุรกรรม ราคาเสนอ สมุดคำสั่งซื้อ OHLCV ประวัติข้อมูล - ข้อมูลสมุดคำสั่งซื้อในอดีตระดับเหตุการณ์สำหรับการเล่นซ้ำ - เซิร์ฟเวอร์ MCP แบบโฮสต์ที่ใช้ได้กับ Cursor และ Claude Desktop - Flat Files แบบจำนวนมากสำหรับงานวิจัยและการเรียนรู้ของเครื่อง - การคิดราคาตามการใช้งานพร้อมเครดิตฟรีสำหรับเริ่มต้น เหมาะที่สุดสำหรับ - แดชบอร์ดข้ามตลาดซื้อขาย ที่เปรียบเทียบอัตราต่อรองระหว่างแพลตฟอร์ม - นักวิจัยเชิงปริมาณและนักวิเคราะห์ ที่ทดสอบย้อนหลังกลยุทธ์ในตลาดทำนายผล - ทีมพยากรณ์และ ML ที่ต้องการข้อมูล OHLCV ย้อนหลังที่สะอาด - งานวิเคราะห์สภาพคล่อง ที่สร้างบนความลึกของสมุดคำสั่งซื้อและสเปรด - ทีม AI ที่สร้างเอเจนต์ซึ่งให้เหตุผลเกี่ยวกับเหตุการณ์ในโลกจริง - งานวิจัยเชิงวิชาการและเศรษฐศาสตร์ เกี่ยวกับวิธีที่ฝูงชนตั้งราคาผลลัพธ์ น่าจะไม่เหมาะสำหรับ - บอทที่ต้องการส่งคำสั่งซื้อ - กลยุทธ์ที่ต้องการสตรีมแบบพุชที่ต่ำกว่าหนึ่งวินาที บทสรุป !assets.apidog.com ตลาดทำนายผลเติบโตเร็วกว่าที่ทีมส่วนใหญ่จะอินทิเกรตทัน ทุกแพลตฟอร์มใหม่นำมาซึ่งตัวระบุใหม่ รูปแบบใหม่ และงานดูแลรักษาใหม่ FinFeedAPI ไม่ได้พยายามเป็นตลาดซื้อขาย มันมุ่งเน้นงานเดียว: เปลี่ยนเก้าแพลตฟอร์มที่กระจัดกระจายให้เป็นชั้นข้อมูลที่เป็นหนึ่งเดียว ตลาด ธุรกรรม ราคาเสนอ สมุดคำสั่งซื้อ OHLCV และประวัติข้อมูลเชิงลึก ทั้งหมดคืนค่ามาในรูปแบบเดียวกัน ผ่าน REST, JSON-RPC, MCP หรือ Flat Files เข้าไปใช้งานโดยรู้ไว้ว่ามันเป็นแบบอ่านอย่างเดียวและแบบคำขอ-ตอบกลับ แล้วมันจะเข้ากับผลิตภัณฑ์ได้หลากหลาย ตั้งแต่แดชบอร์ดพยากรณ์ไปจนถึงเอเจนต์วิจัยด้วย AI เก้าแพลตฟอร์ม หนึ่งสคีมา หนึ่ง API key ลดงานเชื่อมต่อลง เอาเวลาไปสร้างของมากขึ้น เว็บไซต์: finfeedapi.com เอกสาร API: เอกสาร Prediction Markets REST API
@yuvalav @grok @Lee_malach אגב, שמעתי מכמה אנשים אצלנו שזה פרוייקט מעולה לניהול. לא ניסיתי עדיין. greenfield-inc/Pane
A shared core for browser apps in Rust/wasm, no UI framework, client and server from one source Hello. Sharing my recent projects, still at 0.x. I'm building a shared core that builds both the browser client (wasm32) and the native server from the same source, through the development of two apps: a web calendar (day/week/month views, recurring events, reservations) and a tool for the Call of Cthulhu 7e tabletop RPG (character sheets, dice rolls, logs). The core, which I think is the most interesting part, is just wasm-bindgen + web-sys, one event loop owned by the app, the talc allocator, OPFS for local storage (switch to std::fs with unix targets), and a size-tuned release profile. It lives in animagram-jp/app, still 0.0.x, with a first release planned for the end of November (or possibly December). While laying out the calendar I needed bounding-box ops on grids whose columns have their own widths. That became a rectlinear grids library (no-std, optional geometry feature): crates.io A wasm app shouldn't feel heavier than a JS-only one, in bytes shipped, first paint or input latency. No existing CSS framework fit that bar, so I wrote one, now a sibling repo (plain CSS, @layer, renders without JS). Note: I use Claude Code in development. Most translation (to English) and some commits are by them. If something like this already exists, I'd love a pointer. Otherwise, curious whether you find the approach worth pursuing. - animagram-jp/app - animagram-jp/rectgrid - animagram-jp/css For scale: the calendar ships as a 312 KiB wasm (120 KiB gzipped), including argon2 + chacha20poly1305 for the local vault, serde_json, and the whole UI.
Home Assistant integration for Daikin ACs Hey guys, I made this for my friend: gpdl49/ha-daikin-india - thought I'd post it here in case anyone else finds it useful. He's been running it for a month or so now and I've fixed some of the issues he's had. Full disclaimer, it's vibe coded with Claude Code, but I've tried to audit the code as much as possible.
مراجعة FinFeedAPI: واجهة برمجة تطبيقات بيانات أسواق التنبؤات متعددة المنصات تخيل أنك تريد تتبع كيفية تسعير السوق لحدث اقتصادي واحد عبر Kalshi وPolymarket وForecastEx. على الورق، يبدو ذلك كلوحة تحكم بسيطة. لكن عمليًا، يعني ذلك ثلاث واجهات برمجة تطبيقات مختلفة، وثلاث طرق لتحديد السوق نفسه، وثلاث صيغ استجابة يجب التوفيق بينها قبل أن تتمكن من رسم مخطط واحد. {% cta apidog.com %} جرّب Apidog اليوم {% endcta %} وتزداد هذه المشكلة مع كل منصة جديدة. فأسواق التنبؤات تمتد الآن عبر بورصات أمريكية منظَّمة، وبروتوكولات على السلسلة، ومجتمعات بأموال لعبية، وعقود أحداث من منصات تشفير راسخة، ولا تشترك أي منها في نموذج بيانات موحّد. هذه هي الفجوة التي صُمِّم FinFeedAPI لسدّها. فواجهة Prediction Markets API الخاصة به تجمع تسع بورصات تحت مخطط موحّد واحد، بحيث يمكن للمطورين الاستعلام عن الأسواق والصفقات ودفاتر الأوامر والسجل بالطريقة نفسها، بغض النظر عن مصدر البيانات. !منصات أسواق التنبؤات المتعددة بالنسبة للمطورين، يأتي هذا النمو مصحوبًا بحقيقة فوضوية. فكل منصة تكشف عن واجهة برمجية خاصة بها، ومعرّفات أسواق خاصة بها، وأعراف تسمية خاصة بها، وتصوّر خاص بها لشكل «السوق» أصلًا. هل تريد لوحة تحكم تتتبع الحدث نفسه عبر ثلاث منصات؟ الآن أنت تدير ثلاث عمليات تكامل، وثلاثة نماذج بيانات، وثلاث مجموعات من الحالات الحدّية. وهذه بالضبط هي المشكلة التي يحاول FinFeedAPI حلّها. في هذه المراجعة، سأستعرض ما يغطيه Prediction Markets API من FinFeedAPI، وما البيانات التي ستحصل عليها فعلًا، وكيف تبدو نقاط النهاية عمليًا، وكم تبلغ تكلفته، وأين يقصّر، حتى تتمكن من تحديد ما إذا كان يناسب بيئتك التقنية. الملخص السريع (TL;DR) | البند | التفاصيل | | --- | --- | | المزوّد | FinFeedAPI من API Bricks (الشركة نفسها وراء CoinAPI) | | البورصات المغطاة | 9 منصات لأسواق التنبؤات | | البيانات | الأسواق والبيانات الوصفية، الصفقات، التسعيرات، دفاتر الأوامر، OHLCV، ملفات مسطّحة تاريخية | | الوصول | REST، JSON-RPC، خادم MCP مُستضاف، Flat Files (S3) | | الوضع | بيانات سوق للقراءة فقط، طلب-استجابة (بدون بث WebSocket) | | التسعير | أرصدة مجانية للبدء، ثم تسعير حسب الاستخدام يبدأ من 1 دولار لكل 1,000 طلب | | الأفضل لـ | لوحات التحكم متعددة البورصات، البحث، الاختبار الخلفي، وكلاء الذكاء الاصطناعي | ما هو FinFeedAPI؟ !واجهة FinFeedAPI FinFeedAPI هو مزوّد بيانات مالية بنته شركة API Bricks، وهي الشركة نفسها وراء CoinAPI. وإلى جانب واجهات Stock وCurrencies وSEC APIs الخاصة بها، يقدّم Prediction Markets API يمنحك وصولًا موحّدًا إلى بيانات السوق من تسع بورصات لأسواق التنبؤات من خلال تكامل واحد. الفكرة بسيطة: بدلًا من تعلّم تسع واجهات برمجية، تتعلّم واحدة. فمعرّفات الأسواق والنتائج والطوابع الزمنية وبُنى الاستجابة تتبع المخطط نفسه بغض النظر عن البورصة التي جاءت منها البيانات. برزت لي بعض التفاصيل الهندسية أثناء تصفّحي للتوثيق: - نموذج بيانات موحّد عبر كل بورصة مدعومة - معرّفات أسواق موحّدة تتضمن النتيجة، مثل ..._YES و..._NO - طوابع زمنية بتوقيت ISO 8601 UTC على كل نقطة نهاية - دقة رقمية متسقة، حتى 19 رقمًا مع 9 منازل عشرية - أربع طرق للوصول: REST، JSON-RPC، خادم MCP مُستضاف، وFlat Files أمر واحد يجب توضيحه منذ البداية: FinFeedAPI هو طبقة بيانات سوق للقراءة فقط. فهو لا يرسل الأوامر. وإذا كان منتجك يحتاج إلى التنفيذ، فستظل بحاجة إلى استخدام واجهة كل بورصة الأصلية لذلك الجزء. !طبقة البيانات الموحّدة منصات أسواق التنبؤات المدعومة يغطي FinFeedAPI حاليًا تسع منصات، تمتد عبر بورصات منظَّمة وبروتوكولات لامركزية وأسواق نتائج على السلسلة ومجتمع بأموال لعبية. | المنصة | النوع | ما تغطيه | | --- | --- | --- | | Polymarket | لامركزية | السياسة، والاقتصاد، والعملات الرقمية، والرياضة، والأحداث العالمية | | Kalshi | منظَّمة (CFTC) | عقود أحداث أمريكية على المؤشرات الاقتصادية والانتخابات والطقس والرياضة وغيرها | | ForecastEx | منظَّمة (CFTC) | عقود أحداث أمريكية، تشمل النتائج الاقتصادية والمالية | | Gemini Prediction Markets | منظَّمة | عقود أحداث على الرياضة والعملات الرقمية والاقتصاد والسياسة ومواضيع أخرى | | crypto.com Prediction Markets | منظَّمة | عقود قائمة على الأحداث على منصة أسواق التنبؤات الخاصة بـ Crypto.com | | Myriad | لامركزية | العملات الرقمية والأحداث الجارية ونتائج أخرى | | Pascal | لامركزية | أسواق تنبؤات غير وصائية مبنية على Solana | | Hyperliquid Outcome Markets (HIP-4) | أسواق نتائج على السلسلة | عقود أحداث ثنائية ومتعددة النتائج على البنية التحتية الأصلية لـ Hyperliquid | | Manifold Markets | اجتماعية، بأموال لعبية | أسواق يقودها المجتمع في مجموعة واسعة من المواضيع | التنوّع هو ما يجعل هذا مثيرًا للاهتمام. فمقارنة كيفية تسعير منصة منظَّمة، ومنصة مولودة من عالم التشفير، وجمهور بأموال لعبية للحدث نفسه، هي حيث يصبح البحث عبر البورصات قيّمًا. وهي أيضًا حيث يوفّر المخطط الموحّد أكبر قدر من الوقت. ما البيانات التي يمكنك الوصول إليها؟ !مجموعات بيانات أسواق التنبؤات هنا يستحق FinFeedAPI قيمته. فمعظم أدوات أسواق التنبؤات تتوقف عند آخر سعر. أما FinFeedAPI فيكشف السوق بأكمله، من الاستكشاف وصولًا إلى عمق دفتر الأوامر والسجل. جميع نقاط نهاية REST موجودة تحت https://api.prediction-markets.finfeedapi.com/v1. | مجموعة البيانات | نقطة النهاية | ما تحصل عليه | | --- | --- | --- | | البورصات | GET /exchanges و/exchanges/{exchange_id} | المنصات المدعومة، ومعرّفات البورصات، والأوصاف، والمواقع الإلكترونية | | الأسواق النشطة | GET /markets/{exchange_id}/active | قائمة مختصرة بمعرّفات الأسواق النشطة حاليًا | | قوائم الأسواق | GET /markets/{exchange_id}/history | سجلات أسواق كاملة مع ترقيم صفحات قائم على المؤشر: العناوين، والأوصاف، والنتائج، والأسعار، والحالة | | سوق واحد | GET /markets/{exchange_id}/{market_id} | البيانات الوصفية لسوق واحد | | النشاط الحالي | GET /activity/{exchange_id}/{market_id}/current | أحدث صفقة مع أحدث عرض شراء وعرض بيع | | النشاط الأخير | GET /activity/{exchange_id}/{market_id}/latest | الصفقات الأخيرة وتحديثات التسعيرات | | الصفقات والتسعيرات التاريخية | GET /activity/{exchange_id}/{market_id}/history/trades و/history/quotes | سجلات تاريخية تُقدَّم من الملفات المسطّحة | | دفتر الأوامر الحالي | GET /orderbook/{exchange_id}/{market_id}/current | عروض الشراء والبيع لنتيجة سوق | | دفتر الأوامر التاريخي | GET /orderbook/{exchange_id}/{market_id}/history | أحداث أوامر محدّدة خام (إضافات، تحديثات، حذف) لإعادة بناء الدفتر | | OHLCV | GET /ohlcv/periods، /ohlcv/{exchange_id}/{market_id}/history، /latest، /ohlcv/{exchange_id}/history | شموع مع الافتتاح والأعلى والأدنى والإغلاق والحجم وعدد الصفقات | بعض الأمور التي يجدر معرفتها: - الاستكشاف على خطوتين. نقطة النهاية /active تُرجع المعرّفات فقط، لأنها مشتقّة من التسعيرات والصفقات الحديثة. وتستدعي /history أو نقطة نهاية السوق الواحد للحصول على التفاصيل الكاملة. - تمتد فترات OHLCV من الثواني إلى السنوات، وتعود الشموع التاريخية بترتيب زمني تصاعدي، وهو ما تريده للاختبار الخلفي. - بيانات دفتر الأوامر التاريخية على مستوى الأحداث، وليست مجرد لقطات. وهذا يفتح الباب لإعادة تشغيل السوق وبحوث السيولة. - بيانات دورة الحياة والتسوية تغطي الحالات المفتوحة والمغلقة والمسوّاة والمعلَّقة، مع معلومات التسوية حيث تدعمها بورصة المصدر. البدء: طلباتك الأولى التسجيل سريع. تُنشئ حسابًا مجانيًا، وتُنشئ مفتاح API من وحدة التحكم، وتبدأ بأرصدة مجانية. بالنسبة لـ REST وJSON-RPC، تمرّر المفتاح في ترويسة Authorization. ويقبل التوثيق أيضًا X-APIKey وX-APIBricks-Key وX-CoinAPI-Key. 1. اسرد البورصات المدعومة ابدأ من هنا للحصول على قيم exchange_id الدقيقة التي ستستخدمها في كل مكان آخر. curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL]" 2. اكتشف الأسواق النشطة curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "Authorization: YOUR_API_KEY" هذا يُرجع قائمة بسيطة بمعرّفات الأسواق، كل منها يتضمن نتيجته مدمجة: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. احصل على أحدث صفقة وتسعيرة curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] تمنحك الاستجابة أحدث صفقة مع أحدث عرض شراء وعرض بيع لتلك النتيجة. 4. اسحب OHLCV التاريخي بلغة Python هذا هو الاستدعاء الذي سألجأ إليه أولًا عند بناء مخطط احتمالي أو اختبار خلفي. import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) تشمل كل شمعة time_period_start وtime_period_end وprice_open وprice_high وprice_low وprice_close وvolume_traded وtrades_count. واستدعِ /ohlcv/periods لرؤية كل period_id مدعوم. 5. تحقق من عمق دفتر الأوامر curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] تُرجع اللقطة exchange_id وmarket_id وtime_exchange وtime_coinapi، بالإضافة إلى مصفوفتي bids وasks. وهذا كافٍ لحساب الفروق واختلال أفضل عرض في الدفتر. وإذا كنت تفضّل عدم كتابة HTTP خام، تنشر API Bricks حزم تطوير رسمية (Python وNode.js وGo وC# وغيرها) في مستودع SDK على GitHub. ما بعد REST: MCP وJSON-RPC والملفات المسطّحة كل واجهة تكشف مجموعات البيانات الموحّدة نفسها. وتختار الواجهة التي تناسب بنيتك. | الواجهة | ترويسة المصادقة | الأفضل لـ | | --- | --- | --- | | REST API | Authorization | لوحات التحكم، والتحليلات، وتطبيقات الإنتاج | | JSON-RPC API | Authorization | الخدمات التي تفضّل استدعاءات بأسلوب RPC على البيانات نفسها | | خادم MCP مُستضاف | X-APIKey | مساعدو الذكاء الاصطناعي، ووكلاء البرمجة، وسير عمل البحث | | Flat Files (S3) | بيانات اعتماد متوافقة مع S3 | السجلّات الضخمة للاختبار الخلفي وتعلّم الآلة | خادم MCP هو الميزة البارزة من وجهة نظري، هذا هو الجزء الأكثر استشرافًا في المنتج. فبدلًا من تعليم وكيل ذكي وثائق واجهتك البرمجية، توجّهه إلى نقطة نهاية MCP مُستضافة فيكتشف الأدوات بنفسه. الإعداد عبارة عن بضعة أسطر من الإعدادات في Cursor أو Claude Desktop أو أي عميل يدعم MCP: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { [REDACTED CREDENTIAL] } } } } يكشف الخادم حاليًا أدوات من أجل: - استكشاف البورصات: exchanges_list، exchanges_get - استكشاف الأسواق: markets_get_active، markets_get_history - النشاط المباشر: activity_get_current، activity_get_latest - الصفقات والتسعيرات التاريخية: activity_get_trades_history، activity_get_quotes_history - OHLCV: ohlcv_list_periods، ohlcv_get_latest_market، ohlcv_get_history_market، ohlcv_get_history_exchange - دفاتر الأوامر: orderbook_get_current، orderbook_get_history وهذا يعني أنه يمكنك أن تطلب من وكيل ذكي شيئًا مثل «اعثر على أنشط أسواق Kalshi وأرني كيف تحرّكت احتمالاتها هذا الأسبوع» فيستطيع أن يربط استدعاءات الاستكشاف والنشاط وOHLCV بنفسه. ملاحظة إذا كنت قد أعددت اتصال MCP قديمًا بـ FinFeedAPI: انتقلت نقطة النهاية من /sse إلى /mcp، لذا تحتاج الإعدادات الأقدم إلى تحديث. الملفات المسطّحة للسجلّات الضخمة بالنسبة للبحوث واسعة النطاق، فإن سحب سنوات من البيانات عبر استدعاءات REST مُرقَّمة بالصفحات بطيء. تمنحك Flat Files صفقات وتسعيرات ودفاتر أوامر وOHLCV بكميات كبيرة عبر واجهة برمجية متوافقة مع S3، بحيث يمكنك استخدام أدوات وحزم تطوير S3 التي تعرفها بالفعل. التسعير !خطط تسعير FinFeedAPI يستخدم FinFeedAPI تسعيرًا حسب الاستخدام قائمًا على الأرصدة. تبدأ بأرصدة مجانية، ثم تدفع مقابل كل طلب. في خطة الدفع حسب الاستخدام (Pay As You Go)، تبلغ تكلفة أول 1,000 طلب يوميًا 5 دولارات لكل 1,000، وأي شيء يتجاوز 1,000 يوميًا ينخفض إلى 1 دولار لكل 1,000. وتخفض الخطط الالتزامية هذا المعدل. | الخطة | شهريًا | المعدل لكل رصيد | إضافات ملحوظة | | --- | --- | --- | --- | | الدفع حسب الاستخدام | بدون التزام | 1.00 دولار | دعم بالذكاء الاصطناعي والبريد الإلكتروني، وتسجيل ذاتي | | التزامي 64 | 64 دولارًا | 0.85 دولار | تسجيل بمساعدة الذكاء الاصطناعي | | التزامي 256 | 256 دولارًا | 0.75 دولار | تسجيل بمساعدة الذكاء الاصطناعي | | التزامي 512 | 512 دولارًا | 0.70 دولار | دعم على Slack، قناة Slack مخصّصة | | التزامي 1024 | 1,024 دولارًا | 0.65 دولار | اتفاقية مستوى خدمة بنسبة تشغيل 99.9%، ومدير نجاح العملاء، وتسجيل بشري | | المؤسسات | مخصّص | مخصّص | اتفاقيات مستوى خدمة مخصّصة، وتحسينات الكمون، وبنية تحتية مخصّصة | لا تقلل الخطط الالتزامية مما تستهلكه. فهي تمنحك أرصدة أكثر مقابل النفقات نفسها، وبمجرد نفاد تلك الأرصدة، تُحاسَب الاستخدامات الإضافية بمعدل خطة الدفع حسب الاستخدام. يتوفر أيضًا الفوترة السنوية. رأيي: بالنسبة للنماذج الأولية والبحث، خطة الدفع حسب الاستخدام جيدة. أما إذا كنت تستعلم عن أسواق كثيرة كل بضع ثوانٍ، فأجرِ الحسابات أولًا. ينشر FinFeedAPI حالات استخدام للتسعير للوحات التحكم ومراقبة دفاتر الأوامر والتعبئة التاريخية لـ OHLCV، مما يسهّل تقدير التكلفة كثيرًا. أين يقصّر FinFeedAPI لا توجد واجهة برمجية مثالية، والمراجعة التي تتجاهل المقايضات ليست ذات فائدة كبيرة. إليك ما يجب أن تضعه في اعتبارك: - لا يوجد تنفيذ للأوامر. فهو طبقة بيانات فقط. ولا تزال روبوتات التداول بحاجة إلى واجهات البورصات الأصلية لإرسال الأوامر. - لا يوجد بث WebSocket لأسواق التنبؤات. فالبيانات الحالية تأتي عبر استدعاءات طلب-استجابة، لذا يعني «المباشر» الاستعلام الدوري. وبالنسبة للاستراتيجيات الحساسة للكمون، يعد ذلك قيدًا حقيقيًا، كما أن الاستعلام المتكرر يضيف إلى فاتورتك. - أول 1,000 طلب يوميًا هي الأغلى. فبمعدل 5 دولارات لكل 1,000 مقابل 1 دولار لكل 1,000 بعد ذلك، تدفع المشاريع الصغيرة جدًا معدلًا فعليًا أعلى من المشاريع المزدحمة. - تعتمد بيانات التسوية على المصدر. فتفاصيل دورة الحياة والتسوية لا تكون مكتملة إلا بقدر ما تكشفه كل بورصة. - التوحيد مقايضة. المخطط الموحّد هو الهدف كله، لكن إذا كنت تعتمد على حقل خاص بمنصة واحدة، فتحقق من عيّنات البيانات قبل أن تلتزم. لا شيء من هذه الأمور يمثل عائقًا قاطعًا للتحليلات أو البحث أو حالات استخدام الذكاء الاصطناعي. وهي تهم أكثر إذا كنت تبني نظام تداول عالي التردد. من يجب أن يستخدم FinFeedAPI؟ نقاط القوة - تسع منصات لأسواق التنبؤات خلف مخطط واحد - دورة حياة سوق كاملة: الاستكشاف، والصفقات، والتسعيرات، ودفاتر الأوامر، وOHLCV، والسجل - بيانات دفتر أوامر تاريخية على مستوى الأحداث لإعادة التشغيل - خادم MCP مُستضاف يعمل مع Cursor وClaude Desktop - ملفات مسطّحة ضخمة للبحث وتعلّم الآلة - تسعير حسب الاستخدام مع أرصدة مجانية للبدء الأفضل لـ - لوحات التحكم متعددة البورصات التي تقارن الاحتمالات عبر المنصات - الباحثون والمحللون الكمّيون الذين يجرون اختبارات خلفية لاستراتيجيات أسواق التنبؤات - فرق التنبؤ وتعلّم الآلة التي تحتاج إلى OHLCV تاريخي نظيف - تحليلات السيولة المبنية على عمق دفتر الأوامر والفروق - فرق الذكاء الاصطناعي التي تبني وكلاء يستنتجون حول أحداث العالم الواقعي - البحث الأكاديمي والاقتصادي حول كيفية تسعير الجماهير للنتائج غالبًا ليس لـ - الروبوتات التي تحتاج إلى إرسال الأوامر - الاستراتيجيات التي تحتاج إلى بث قائم على الدفع دون ثانية أفكار ختامية !شبكة بيانات أسواق التنبؤات تنمو أسواق التنبؤات أسرع مما تستطيع معظم الفرق دمجه. فكل منصة جديدة تجلب معرّفات جديدة وصيغًا جديدة وعمل صيانة جديدًا. لا يحاول FinFeedAPI أن يكون بورصة. بل يركّز على مهمة واحدة: تحويل تسع منصات مجزّأة إلى طبقة بيانات متسقة واحدة. فتعود الأسواق والصفقات والتسعيرات ودفاتر الأوامر وOHLCV والسجل العميق بالشكل نفسه، عبر REST أو JSON-RPC أو MCP أو Flat Files. ادخل إليه مدركًا أنه للقراءة فقط وبأسلوب طلب-استجابة، وسيناسب مجموعة واسعة من المنتجات، من لوحات التحكم في التنبؤات إلى وكلاء البحث بالذكاء الاصطناعي. تسع منصات. مخطط واحد. مفتاح API واحد. بنية أقل، وبناء أكثر. الموقع الإلكتروني: finfeedapi.com توثيق API: توثيق Prediction Markets REST API
@JoseMP2101 github.com/Awis13/liberty-pro-max/releases For Mac OS just download a Builder and point it to installed .exe t.co
Some 0.57.0 regressions including black screens, keybind issues, config issues, etc. have now been fixed with the 0.57.1 update :) github.com/hyprwm/Hyprland/releases/tag/v0.57.1
I built a pixel-art hive that shows what all my Claude Code agents are doing I run a lot of Claude Code sessions and sub-agents at the same time, and I kept losing track of who's working, who's stuck waiting on me, and who just finished and is sitting idle. So I built BeeKeeper 🐝 - a hive of pixel-art rooms. Every project folder is a room, every Claude Code session and sub-agent is a little character in it. When an agent is called it walks in, sits down and types while it works. When it's done it waits for you, and eventually falls asleep (Zzz). A speech bubble shows what each one is doing right now. How it works: - Runs locally. It reads your Claude Code chat logs from your own machine, nothing is uploaded anywhere - Every folder you've used Claude Code in becomes a room automatically - Agents tab with all your agents and skills, how often each one was called - 20 free ready-made rooms and 17 pixel characters to assign to your agents - Optional: generate your own rooms in any theme with Gemini (about 10 cents a room, your own key) - Works on mobile too Built entirely with Claude Code. Free and open source (MIT): ranucho/beekeeper Would love feedback, especially from people running many agents in parallel.
Three research prototypes, one problem each. 1. Jobs keep running when nodes disappear and packets drop. 2. A 2048-tile baseband stays under 4 W. 3. Structure-preserving advection that still returns Cd and Cl. Public taster (one command): JadeSileyWinditt/sovereign-compute-taster Full source by request. jadesileywinditt@gmail.com #SovereignCompute #6G #Aerodynamics
tenferro-rsは,RustのSciML基盤として進化する予定 tenferro-rs#2419
@vincent_koc Don't forget to add the mandatory Turbo-style IDE after own language! Here was my own from a while ago miguelbranco80/draft and... 200 agents? oufff, cool! t.co
Đánh giá FinFeedAPI: API dữ liệu thị trường dự đoán đa sàn Hãy tưởng tượng bạn muốn theo dõi cách thị trường định giá một sự kiện kinh tế duy nhất trên Kalshi, Polymarket và ForecastEx. Trên lý thuyết, nghe có vẻ như chỉ là một dashboard đơn giản. Trên thực tế, điều đó có nghĩa là ba API khác nhau, ba cách xác định cùng một thị trường, và ba định dạng phản hồi cần phải dung hòa trước khi bạn có thể vẽ nổi một biểu đồ. {% cta apidog.com %} Dùng thử Apidog ngay hôm nay {% endcta %} Vấn đề đó càng lớn hơn với mỗi sàn mới. Các thị trường dự đoán hiện nay trải rộng từ các sàn giao dịch được quản lý tại Mỹ, các giao thức on-chain, các cộng đồng chơi bằng tiền ảo, cho đến các hợp đồng sự kiện từ những nền tảng crypto lâu đời, và không có sàn nào trong số đó chia sẻ một mô hình dữ liệu chung. Đây chính là khoảng trống mà FinFeedAPI được tạo ra để lấp đầy. Prediction Markets API của nó đưa chín sàn giao dịch về dưới một schema được chuẩn hóa, giúp các nhà phát triển có thể truy vấn thị trường, giao dịch, sổ lệnh và lịch sử theo cùng một cách, bất kể dữ liệu đến từ đâu. !assets.apidog.com Đối với các nhà phát triển, sự tăng trưởng đó đi kèm với một sự thật phức tạp. Mỗi sàn đều phơi bày API riêng, mã định danh thị trường riêng, quy ước đặt tên riêng, và quan niệm riêng về việc một "thị trường" thậm chí trông như thế nào. Muốn có một dashboard theo dõi cùng một sự kiện trên ba nền tảng? Giờ bạn phải duy trì ba tích hợp, ba mô hình dữ liệu và ba tập hợp các trường hợp biên. Đó chính xác là vấn đề mà FinFeedAPI đang cố gắng giải quyết. Trong bài đánh giá này, tôi sẽ đi qua những gì Prediction Markets API của FinFeedAPI bao phủ, bạn thực sự nhận được dữ liệu gì, các endpoint trông như thế nào trong thực tế, chi phí ra sao, và nó còn thiếu sót ở đâu, để bạn có thể quyết định liệu nó có phù hợp với stack của mình hay không. TL;DR | Tiêu chí | Chi tiết | | --- | --- | | Nhà cung cấp | FinFeedAPI bởi API Bricks (cũng đứng sau CoinAPI) | | Các sàn được hỗ trợ | 9 sàn thị trường dự đoán | | Dữ liệu | Thị trường và metadata, giao dịch, báo giá, sổ lệnh, OHLCV, tệp phẳng lịch sử | | Truy cập | REST, JSON-RPC, máy chủ MCP được host, Flat Files (S3) | | Chế độ | Dữ liệu thị trường chỉ đọc, request-response (không có luồng WebSocket) | | Giá | Tín dụng miễn phí để bắt đầu, sau đó tính theo mức sử dụng từ $1 cho mỗi 1.000 yêu cầu | | Phù hợp nhất cho | Dashboard đa sàn, nghiên cứu, backtesting, AI agent | FinFeedAPI là gì? !assets.apidog.com FinFeedAPI là một nhà cung cấp dữ liệu tài chính được xây dựng bởi API Bricks, cùng công ty đứng sau CoinAPI. Bên cạnh các API Stock, Currencies và SEC, nó cung cấp một Prediction Markets API cho phép bạn truy cập được chuẩn hóa vào dữ liệu thị trường từ chín sàn thị trường dự đoán thông qua một tích hợp duy nhất. Ý tưởng rất đơn giản: thay vì học chín API, bạn chỉ học một. Mã thị trường, kết quả, dấu thời gian và cấu trúc phản hồi đều tuân theo cùng một schema bất kể dữ liệu đến từ sàn nào. Một vài chi tiết kỹ thuật nổi bật với tôi khi đọc qua tài liệu: - Mô hình dữ liệu thống nhất trên mọi sàn được hỗ trợ - Mã thị trường được chuẩn hóa bao gồm cả kết quả, ví dụ ..._YES và ..._NO - Dấu thời gian ISO 8601 UTC trên mọi endpoint - Độ chính xác số nhất quán, lên tới 19 chữ số với 9 chữ số thập phân - Bốn cách truy cập: REST, JSON-RPC, máy chủ MCP được host, và Flat Files Một điều cần nói rõ ngay từ đầu: FinFeedAPI là một lớp dữ liệu thị trường chỉ đọc. Nó không đặt lệnh. Nếu sản phẩm của bạn cần khớp lệnh, bạn vẫn sẽ phải dùng API gốc của từng sàn cho phần đó. !assets.apidog.com Các nền tảng thị trường dự đoán được hỗ trợ FinFeedAPI hiện bao phủ chín sàn, trải rộng từ các sàn được quản lý, các giao thức phi tập trung, các thị trường kết quả on-chain, cho đến một cộng đồng chơi bằng tiền ảo. | Nền tảng | Loại | Phạm vi bao phủ | | --- | --- | --- | | Polymarket | Phi tập trung | Chính trị, kinh tế, crypto, thể thao và các sự kiện toàn cầu | | Kalshi | Được quản lý (CFTC) | Các hợp đồng sự kiện tại Mỹ về chỉ số kinh tế, bầu cử, thời tiết, thể thao và hơn thế nữa | | ForecastEx | Được quản lý (CFTC) | Các hợp đồng sự kiện tại Mỹ, bao gồm các kết quả kinh tế và tài chính | | Gemini Prediction Markets | Được quản lý | Hợp đồng sự kiện về thể thao, crypto, kinh tế, chính trị và các chủ đề khác | | Crypto.com Prediction Markets | Được quản lý | Các hợp đồng dựa trên sự kiện trên nền tảng thị trường dự đoán của Crypto.com | | Myriad | Phi tập trung | Crypto, các sự kiện thời sự và các kết quả khác | | Pascal | Phi tập trung | Các thị trường dự đoán không lưu ký được xây dựng trên Solana | | Hyperliquid Outcome Markets (HIP-4) | Thị trường kết quả on-chain | Các hợp đồng sự kiện nhị phân và đa kết quả trên hạ tầng gốc của Hyperliquid | | Manifold Markets | Xã hội, tiền ảo | Các thị trường do cộng đồng dẫn dắt trên nhiều chủ đề | Sự kết hợp này chính là điều khiến nó thú vị. So sánh cách một sàn được quản lý, một sàn crypto-native và một đám đông chơi bằng tiền ảo định giá cùng một sự kiện chính là nơi nghiên cứu đa sàn trở nên có giá trị. Đó cũng là nơi một schema được chuẩn hóa tiết kiệm được nhiều thời gian nhất. Bạn có thể truy cập những dữ liệu nào? !assets.apidog.com Đây là nơi FinFeedAPI chứng minh được giá trị của mình. Hầu hết các công cụ thị trường dự đoán chỉ dừng ở mức giá mới nhất. FinFeedAPI phơi bày toàn bộ thị trường, từ bước khám phá cho tới độ sâu sổ lệnh và lịch sử. Tất cả các endpoint REST đều nằm dưới https://api.prediction-markets.finfeedapi.com/v1. | Tập dữ liệu | Endpoint | Bạn nhận được gì | | --- | --- | --- | | Các sàn | GET /exchanges và /exchanges/{exchange_id} | Các sàn được hỗ trợ, ID sàn, mô tả, website | | Thị trường đang hoạt động | GET /markets/{exchange_id}/active | Danh sách gọn các mã thị trường hiện đang hoạt động | | Danh sách thị trường | GET /markets/{exchange_id}/history | Bản ghi thị trường đầy đủ với phân trang dựa trên con trỏ: tiêu đề, mô tả, kết quả, giá, trạng thái | | Một thị trường đơn lẻ | GET /markets/{exchange_id}/{market_id} | Metadata của một thị trường | | Hoạt động hiện tại | GET /activity/{exchange_id}/{market_id}/current | Giao dịch mới nhất cùng giá chào mua và chào bán mới nhất | | Hoạt động gần đây | GET /activity/{exchange_id}/{market_id}/latest | Các giao dịch và cập nhật báo giá gần đây | | Giao dịch và báo giá lịch sử | GET /activity/{exchange_id}/{market_id}/history/trades và /history/quotes | Bản ghi lịch sử được phục vụ từ tệp phẳng | | Sổ lệnh hiện tại | GET /orderbook/{exchange_id}/{market_id}/current | Lệnh chào mua và chào bán cho một kết quả thị trường | | Sổ lệnh lịch sử | GET /orderbook/{exchange_id}/{market_id}/history | Các sự kiện lệnh giới hạn thô (thêm, cập nhật, xóa) để tái dựng sổ lệnh | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | Nến với giá mở, cao, thấp, đóng, khối lượng và số lượng giao dịch | Một vài điều đáng lưu ý: - Khám phá gồm hai bước. Endpoint /active chỉ trả về các ID, vì nó được suy ra từ các báo giá và giao dịch gần đây. Bạn gọi /history hoặc endpoint thị trường đơn lẻ để lấy thông tin đầy đủ. - Chu kỳ OHLCV trải từ vài giây cho tới vài năm, và các nến lịch sử được trả về theo thứ tự thời gian tăng dần, đúng như những gì bạn cần cho backtesting. - Dữ liệu sổ lệnh lịch sử ở mức sự kiện, chứ không chỉ là ảnh chụp nhanh. Điều đó mở ra khả năng phát lại thị trường và nghiên cứu thanh khoản. - Dữ liệu vòng đời và giải quyết bao gồm các trạng thái mở, đóng, đã giải quyết và tạm ngưng, cùng thông tin giải quyết ở những nơi sàn nguồn hỗ trợ. Bắt đầu: Những yêu cầu đầu tiên của bạn Việc làm quen rất nhanh. Bạn tạo một tài khoản miễn phí, tạo API key từ console, và bắt đầu với tín dụng miễn phí. Với REST và JSON-RPC, bạn truyền key trong header Authorization. Tài liệu cũng chấp nhận X-APIKey, X-APIBricks-Key và X-CoinAPI-Key. 1. Liệt kê các sàn được hỗ trợ Bắt đầu từ đây để lấy các giá trị exchange_id chính xác mà bạn sẽ dùng ở mọi nơi khác. curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL] 2. Khám phá các thị trường đang hoạt động curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] Lệnh này trả về một danh sách thuần các mã thị trường, mỗi mã đã bao gồm kết quả của nó: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. Lấy giao dịch và báo giá mới nhất curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL]_API_KEY" Phản hồi cung cấp cho bạn giao dịch mới nhất cùng giá chào mua và chào bán mới nhất cho kết quả đó. 4. Kéo dữ liệu OHLCV lịch sử bằng Python Đây là lệnh gọi mà tôi sẽ dùng đầu tiên khi xây dựng một biểu đồ xác suất hoặc một bài backtest. import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {"Authorization": API_KEY} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) Mỗi nến bao gồm time_period_start, time_period_end, price_open, price_high, price_low, price_close, volume_traded và trades_count. Gọi /ohlcv/periods để xem mọi period_id được hỗ trợ. 5. Kiểm tra độ sâu sổ lệnh curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] Ảnh chụp nhanh trả về exchange_id, market_id, time_exchange, time_coinapi, cùng các mảng bids và asks. Như vậy là đủ để tính chênh lệch giá và mất cân bằng ở đầu sổ lệnh. Nếu bạn không muốn tự viết HTTP thô, API Bricks có phát hành các SDK chính thức (Python, Node.js, Go, C# và nhiều ngôn ngữ khác) trong kho SDK trên GitHub của mình. Ngoài REST: MCP, JSON-RPC và Flat Files Mọi giao diện đều phơi bày cùng các tập dữ liệu được chuẩn hóa. Bạn chọn cái phù hợp với kiến trúc của mình. | Giao diện | Header xác thực | Phù hợp nhất cho | | --- | --- | --- | | REST API | Authorization | Dashboard, phân tích, ứng dụng production | | JSON-RPC API | Authorization | Các dịch vụ thích gọi kiểu RPC hơn là dùng cùng dữ liệu | | Máy chủ MCP được host | X-APIKey | Trợ lý AI, agent lập trình, quy trình nghiên cứu | | Flat Files (S3) | Thông tin xác thực tương thích S3 | Lịch sử khối lượng lớn cho backtesting và machine learning | Máy chủ MCP là điểm nổi bật Theo góc nhìn của tôi, đây là phần có tầm nhìn xa nhất của sản phẩm. Thay vì dạy cho agent tài liệu API của bạn, bạn chỉ cần trỏ nó tới một endpoint MCP được host và nó sẽ tự khám phá các công cụ. Việc thiết lập chỉ gồm vài dòng cấu hình trong Cursor, Claude Desktop, hoặc bất kỳ client hỗ trợ MCP nào: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { [REDACTED CREDENTIAL] } } } } Máy chủ hiện phơi bày các công cụ cho: - Khám phá sàn: exchanges_list, exchanges_get - Khám phá thị trường: markets_get_active, markets_get_history - Hoạt động trực tiếp: activity_get_current, activity_get_latest - Giao dịch và báo giá lịch sử: activity_get_trades_history, activity_get_quotes_history - OHLCV: ohlcv_list_periods, ohlcv_get_latest_market, ohlcv_get_history_market, ohlcv_get_history_exchange - Sổ lệnh: orderbook_get_current, orderbook_get_history Điều đó có nghĩa là bạn có thể hỏi một agent điều gì đó như "tìm những thị trường Kalshi đang hoạt động sôi nổi nhất và cho tôi xem tỷ lệ cược của chúng đã thay đổi thế nào trong tuần này" và nó có thể tự mình chuỗi các lệnh gọi khám phá, hoạt động và OHLCV lại với nhau. Một lưu ý nếu bạn thiết lập kết nối MCP FinFeedAPI cũ hơn: endpoint đã chuyển từ /sse sang /mcp, nên các cấu hình cũ cần được cập nhật. Flat Files cho lịch sử nặng Đối với nghiên cứu quy mô lớn, việc kéo dữ liệu nhiều năm qua các lệnh gọi REST phân trang sẽ rất chậm. Flat Files cung cấp cho bạn giao dịch, báo giá, sổ lệnh và OHLCV dạng khối lượng lớn thông qua một API tương thích S3, để bạn có thể dùng chính những công cụ và SDK S3 mà bạn đã quen thuộc. Giá cả !assets.apidog.com FinFeedAPI sử dụng mô hình giá theo mức sử dụng dựa trên tín dụng. Bạn bắt đầu với tín dụng miễn phí, sau đó trả tiền theo từng yêu cầu. Ở gói Pay As You Go, 1.000 yêu cầu đầu tiên mỗi ngày có giá $5 cho mỗi 1.000, và bất cứ thứ gì vượt quá 1.000 mỗi ngày sẽ giảm xuống còn $1 cho mỗi 1.000. Các gói cam kết sẽ hạ mức giá đó xuống thấp hơn. | Gói | Hàng tháng | Giá mỗi tín dụng | Các ưu đãi đáng chú ý | | --- | --- | --- | --- | | Pay As You Go | Không ràng buộc | $1.00 | Hỗ trợ qua AI và email, tự phục vụ onboarding | | Committed 64 | $64 | $0.85 | Onboarding có hỗ trợ AI | | Committed 256 | $256 | $0.75 | Onboarding có hỗ trợ AI | | Committed 512 | $512 | $0.70 | Hỗ trợ qua Slack, kênh Slack riêng | | Committed 1024 | $1,024 | $0.65 | SLA uptime 99,9%, chuyên viên customer success, onboarding do con người thực hiện | | Enterprise | Tùy chỉnh | Tùy chỉnh | SLA tùy chỉnh, tối ưu độ trễ, hạ tầng riêng | Các gói cam kết không làm giảm lượng bạn sử dụng. Chúng cho bạn nhiều tín dụng hơn với cùng mức chi tiêu, và khi số tín dụng đó cạn, phần sử dụng thêm sẽ được tính theo giá Pay As You Go. Thanh toán theo năm cũng có sẵn. Quan điểm của tôi: với nguyên mẫu và nghiên cứu, Pay As You Go là ổn. Nếu bạn đang polling nhiều thị trường vài giây một lần, hãy tính toán trước. FinFeedAPI có công bố các trường hợp sử dụng giá cho dashboard, giám sát sổ lệnh và backfill OHLCV, giúp việc ước tính dễ dàng hơn nhiều. FinFeedAPI còn thiếu sót ở đâu Không có API nào hoàn hảo, và một bài đánh giá bỏ qua các đánh đổi thì chẳng có ích gì. Đây là những điều cần ghi nhớ: - Không có khớp lệnh. Đây chỉ là một lớp dữ liệu. Bot giao dịch vẫn cần API gốc của sàn để đặt lệnh. - Không có luồng WebSocket cho thị trường dự đoán. Dữ liệu hiện tại đến qua các lệnh gọi request-response, nên "trực tiếp" có nghĩa là polling. Với các chiến lược nhạy cảm với độ trễ, đó là một hạn chế thật sự, và việc polling thường xuyên sẽ làm tăng hóa đơn của bạn. - 1.000 yêu cầu đầu tiên mỗi ngày là đắt nhất. Ở mức $5 cho mỗi 1.000 so với $1 cho mỗi 1.000 sau đó, những dự án rất nhỏ phải trả mức giá hiệu dụng cao hơn những dự án bận rộn. - Dữ liệu giải quyết phụ thuộc vào nguồn. Thông tin vòng đời và giải quyết chỉ đầy đủ bằng những gì mà mỗi sàn phơi bày. - Việc chuẩn hóa là một sự đánh đổi. Schema thống nhất chính là mục đích, nhưng nếu bạn phụ thuộc vào một trường riêng của một sàn nào đó, hãy kiểm tra các mẫu dữ liệu trước khi cam kết. Không có điểm nào trong số này là trở ngại chết người đối với các trường hợp sử dụng phân tích, nghiên cứu hay AI. Chúng quan trọng nhất nếu bạn đang xây dựng một hệ thống giao dịch tần suất cao. Ai nên dùng FinFeedAPI? Điểm mạnh - Chín sàn thị trường dự đoán dưới một schema duy nhất - Toàn bộ vòng đời thị trường: khám phá, giao dịch, báo giá, sổ lệnh, OHLCV, lịch sử - Dữ liệu sổ lệnh lịch sử ở mức sự kiện để phát lại - Máy chủ MCP được host hoạt động với Cursor và Claude Desktop - Flat Files khối lượng lớn cho nghiên cứu và machine learning - Giá theo mức sử dụng với tín dụng miễn phí để bắt đầu Phù hợp nhất cho - Dashboard đa sàn so sánh tỷ lệ cược giữa các sàn - Nhà nghiên cứu định lượng và chuyên viên phân tích backtest các chiến lược thị trường dự đoán - Đội ngũ dự báo và ML cần dữ liệu OHLCV lịch sử sạch - Phân tích thanh khoản dựa trên độ sâu sổ lệnh và chênh lệch giá - Đội ngũ AI xây dựng các agent lập luận về các sự kiện thực tế - Nghiên cứu học thuật và kinh tế về cách đám đông định giá các kết quả Có lẽ không phù hợp cho - Các bot cần đặt lệnh - Các chiến lược cần một luồng đẩy, dưới một giây Suy nghĩ cuối cùng !assets.apidog.com Các thị trường dự đoán đang tăng trưởng nhanh hơn khả năng tích hợp của hầu hết các đội ngũ. Mỗi sàn mới mang đến những mã định danh mới, định dạng mới và công việc bảo trì mới. FinFeedAPI không cố gắng trở thành một sàn giao dịch. Nó tập trung vào một việc duy nhất: biến chín sàn phân mảnh thành một lớp dữ liệu nhất quán. Thị trường, giao dịch, báo giá, sổ lệnh, OHLCV và lịch sử sâu đều được trả về với cùng một hình dạng, thông qua REST, JSON-RPC, MCP hoặc Flat Files. Hãy bước vào với hiểu biết rằng nó chỉ đọc và theo kiểu request-response, và nó phù hợp với rất nhiều sản phẩm, từ dashboard dự báo cho tới các agent nghiên cứu AI. Chín sàn. Một schema. Một API key. Ít việc nối hệ thống hơn, nhiều việc xây dựng hơn. Website: finfeedapi.com Tài liệu API: Tài liệu REST API của Prediction Markets
Análise do FinFeedAPI: API de Dados de Mercado de Previsão Multi-Exchange Imagine que você quer acompanhar como o mercado precifica um único evento econômico na Kalshi, na Polymarket e na ForecastEx. No papel, isso parece um dashboard simples. Na prática, significa três APIs diferentes, três formas de identificar o mesmo mercado e três formatos de resposta para conciliar antes de conseguir desenhar um único gráfico. {% cta apidog.com %} Experimente o Apidog hoje {% endcta %} Esse problema cresce a cada nova plataforma. Os mercados de previsão agora abrangem exchanges reguladas nos EUA, protocolos on-chain, comunidades com dinheiro fictício e contratos de eventos de plataformas cripto estabelecidas, e nenhuma delas compartilha um modelo de dados comum. É essa lacuna que a FinFeedAPI foi criada para preencher. Sua Prediction Markets API reúne nove exchanges sob um único esquema padronizado, para que os desenvolvedores possam consultar mercados, negociações, livros de ofertas e histórico da mesma forma, independentemente de onde os dados venham. !Rede de mercados de previsão conectada por uma única API Para os desenvolvedores, esse crescimento vem acompanhado de uma verdade incômoda. Cada plataforma expõe sua própria API, seus próprios identificadores de mercado, suas próprias convenções de nomenclatura e sua própria ideia do que um "mercado" sequer parece ser. Quer um dashboard que acompanhe o mesmo evento em três plataformas? Agora você está mantendo três integrações, três modelos de dados e três conjuntos de casos extremos. É exatamente esse o problema que a FinFeedAPI está tentando resolver. Nesta análise, vou percorrer o que a Prediction Markets API da FinFeedAPI cobre, quais dados você realmente obtém, como os endpoints se parecem na prática, quanto custa e onde ela fica devendo, para que você possa decidir se ela se encaixa na sua stack. TL;DR | | | | --- | --- | | Fornecedor | FinFeedAPI da API Bricks (também por trás da CoinAPI) | | Exchanges cobertas | 9 plataformas de mercados de previsão | | Dados | Mercados e metadados, negociações, cotações, livros de ofertas, OHLCV, arquivos históricos estáticos | | Acesso | REST, JSON-RPC, servidor MCP hospedado, Flat Files (S3) | | Modo | Dados de mercado somente leitura, requisição-resposta (sem stream WebSocket) | | Preços | Créditos gratuitos para começar, depois baseado em uso a partir de $1 por 1.000 requisições | | Ideal para | Dashboards entre exchanges, pesquisa, backtesting, agentes de IA | O que é a FinFeedAPI? !Visão geral da FinFeedAPI A FinFeedAPI é um provedor de dados financeiros criado pela API Bricks, a mesma empresa por trás da CoinAPI. Além de suas APIs de Ações, Moedas e SEC, ela oferece uma Prediction Markets API que dá acesso padronizado a dados de mercado de nove exchanges de mercados de previsão por meio de uma única integração. A ideia é simples: em vez de aprender nove APIs, você aprende uma. IDs de mercado, resultados, timestamps e estruturas de resposta seguem o mesmo esquema, não importa de qual exchange os dados vieram. Alguns detalhes de engenharia me chamaram a atenção ao percorrer a documentação: - Modelo de dados unificado em todas as exchanges suportadas - IDs de mercado padronizados que incluem o resultado, por exemplo ..._YES e ..._NO - Timestamps ISO 8601 UTC em todos os endpoints - Precisão numérica consistente, de até 19 dígitos com 9 casas decimais - Quatro formas de acesso: REST, JSON-RPC, um servidor MCP hospedado e Flat Files Uma coisa a deixar clara desde o início: a FinFeedAPI é uma camada de dados de mercado somente leitura. Ela não realiza ordens. Se o seu produto precisa de execução, você ainda usará a API nativa de cada exchange para essa parte. !Exchanges de mercados de previsão cobertas pela FinFeedAPI Plataformas de Mercados de Previsão Suportadas Atualmente, a FinFeedAPI cobre nove plataformas, abrangendo exchanges reguladas, protocolos descentralizados, mercados de resultados on-chain e uma comunidade com dinheiro fictício. | Plataforma | Tipo | O que cobre | | --- | --- | --- | | Polymarket | Descentralizada | Política, economia, cripto, esportes e eventos globais | | Kalshi | Regulada (CFTC) | Contratos de eventos dos EUA sobre indicadores econômicos, eleições, clima, esportes e mais | | ForecastEx | Regulada (CFTC) | Contratos de eventos dos EUA, incluindo resultados econômicos e financeiros | | Gemini Prediction Markets | Regulada | Contratos de eventos sobre esportes, cripto, economia, política e outros temas | | crypto.com Prediction Markets | Regulada | Contratos baseados em eventos na plataforma de mercados de previsão da crypto.com | | Myriad | Descentralizada | Cripto, eventos atuais e outros resultados | | Pascal | Descentralizada | Mercados de previsão sem custódia construídos na Solana | | Hyperliquid Outcome Markets (HIP-4) | Mercados de resultados on-chain | Contratos de eventos binários e com múltiplos resultados na infraestrutura nativa da Hyperliquid | | Manifold Markets | Social, dinheiro fictício | Mercados impulsionados pela comunidade sobre uma ampla variedade de temas | É a mistura que torna isso interessante. Comparar como uma plataforma regulada, uma plataforma nativa de cripto e uma multidão que usa dinheiro fictício precificam o mesmo evento é onde a pesquisa entre exchanges se torna valiosa. É também onde um esquema normalizado economiza mais tempo. Quais Dados Você Pode Acessar? !Conjuntos de dados disponíveis na Prediction Markets API É aqui que a FinFeedAPI justifica seu valor. A maioria das ferramentas de mercados de previsão para no preço mais recente. A FinFeedAPI expõe o mercado inteiro, desde a descoberta até a profundidade do livro de ofertas e o histórico. Todos os endpoints REST ficam em https://api.prediction-markets.finfeedapi.com/v1. | Conjunto de dados | Endpoint | O que você obtém | | --- | --- | --- | | Exchanges | GET /exchanges e /exchanges/{exchange_id} | Plataformas suportadas, IDs de exchange, descrições, sites | | Mercados ativos | GET /markets/{exchange_id}/active | Uma lista compacta de IDs de mercados atualmente ativos | | Listagens de mercados | GET /markets/{exchange_id}/history | Registros completos de mercados com paginação baseada em cursor: títulos, descrições, resultados, preços, status | | Mercado único | GET /markets/{exchange_id}/{market_id} | Metadados de um mercado | | Atividade atual | GET /activity/{exchange_id}/{market_id}/current | Última negociação mais último bid e ask | | Atividade recente | GET /activity/{exchange_id}/{market_id}/latest | Negociações recentes e atualizações de cotações | | Negociações e cotações históricas | GET /activity/{exchange_id}/{market_id}/history/trades e /history/quotes | Registros históricos servidos a partir de arquivos estáticos | | Livro de ofertas atual | GET /orderbook/{exchange_id}/{market_id}/current | Bids e asks para um resultado de mercado | | Livro de ofertas histórico | GET /orderbook/{exchange_id}/{market_id}/history | Eventos brutos de ordens limitadas (adições, atualizações, exclusões) para reconstrução do livro | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | Candles com abertura, máxima, mínima, fechamento, volume e contagem de negociações | Algumas coisas que vale a pena saber: - A descoberta é em duas etapas. O endpoint /active retorna apenas IDs, porque é derivado de cotações e negociações recentes. Você chama /history ou o endpoint de mercado único para obter detalhes completos. - Os períodos OHLCV vão de segundos até anos, e os candles históricos retornam em ordem cronológica crescente, que é o que você quer para backtesting. - Os dados históricos do livro de ofertas são em nível de evento, não apenas snapshots. Isso abre a porta para replay de mercado e pesquisa de liquidez. - Os dados de ciclo de vida e resolução cobrem os status aberto, fechado, resolvido e suspenso, com informações de resolução onde a exchange de origem oferece suporte. Primeiros Passos: Suas Primeiras Requisições O onboarding é rápido. Você cria uma conta gratuita, gera uma chave de API no console e começa com créditos gratuitos. Para REST e JSON-RPC, você passa a chave no cabeçalho Authorization. A documentação também aceita X-APIKey, X-APIBricks-Key e X-CoinAPI-Key. 1. Liste as exchanges suportadas Comece aqui para obter os valores exatos de exchange_id que você usará em todo o resto. curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL] 2. Descubra mercados ativos curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] Isso retorna uma lista simples de IDs de mercado, cada um com seu resultado já embutido: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. Obtenha a última negociação e cotação curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] A resposta fornece a última negociação juntamente com o último bid e ask para aquele resultado. 4. Obtenha OHLCV histórico em Python Esta é a chamada que eu usaria primeiro ao construir um gráfico de probabilidade ou um backtest. import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) Cada candle inclui time_period_start, time_period_end, price_open, price_high, price_low, price_close, volume_traded e trades_count. Chame /ohlcv/periods para ver todos os period_id suportados. 5. Verifique a profundidade do livro de ofertas curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] O snapshot retorna exchange_id, market_id, time_exchange, time_coinapi, além dos arrays bids e asks. Isso é suficiente para calcular spreads e desequilíbrio no topo do livro. Se você preferir não escrever HTTP bruto, a API Bricks publica SDKs oficiais (Python, Node.js, Go, C# e outros) em seu repositório de SDKs no GitHub. Além do REST: MCP, JSON-RPC e Flat Files Toda interface expõe os mesmos conjuntos de dados padronizados. Você escolhe a que combina com sua arquitetura. | Interface | Cabeçalho de autenticação | Ideal para | | --- | --- | --- | | API REST | Authorization | Dashboards, análises, aplicações em produção | | API JSON-RPC | Authorization | Serviços que preferem chamadas no estilo RPC sobre os mesmos dados | | Servidor MCP hospedado | X-APIKey | Assistentes de IA, agentes de código, fluxos de pesquisa | | Flat Files (S3) | Credenciais compatíveis com S3 | Histórico em massa para backtesting e aprendizado de máquina | O servidor MCP é o destaque Do meu ponto de vista, esta é a parte mais visionária do produto. Em vez de ensinar a documentação da sua API a um agente, você o aponta para um endpoint MCP hospedado e ele descobre as ferramentas sozinho. A configuração são algumas linhas de config no Cursor, no Claude Desktop ou em qualquer cliente compatível com MCP: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { "X-APIKey": "YOUR_API_KEY_HERE" } } } } Atualmente, o servidor expõe ferramentas para: - Descoberta de exchanges: exchanges_list, exchanges_get - Descoberta de mercados: markets_get_active, markets_get_history - Atividade ao vivo: activity_get_current, activity_get_latest - Negociações e cotações históricas: activity_get_trades_history, activity_get_quotes_history - OHLCV: ohlcv_list_periods, ohlcv_get_latest_market, ohlcv_get_history_market, ohlcv_get_history_exchange - Livros de ofertas: orderbook_get_current, orderbook_get_history Isso significa que você pode pedir a um agente algo como "encontre os mercados mais ativos da Kalshi e me mostre como as probabilidades deles se moveram esta semana" e ele pode encadear chamadas de descoberta, atividade e OHLCV por conta própria. Uma observação, caso você configure uma conexão MCP mais antiga da FinFeedAPI: o endpoint mudou de /sse para /mcp, então configurações antigas precisam ser atualizadas. Flat Files para histórico pesado Para pesquisa em larga escala, extrair anos de dados por meio de chamadas REST paginadas é lento. Os Flat Files fornecem negociações, cotações, livros de ofertas e OHLCV em massa por meio de uma API compatível com S3, para que você possa usar as ferramentas e SDKs S3 que já conhece. Preços !Planos de preços da FinFeedAPI A FinFeedAPI usa preços baseados em uso, com créditos. Você começa com créditos gratuitos e depois paga por requisição. No Pay As You Go, as primeiras 1.000 requisições por dia custam $5 por 1.000, e qualquer coisa além de 1.000 por dia cai para $1 por 1.000. Planos com compromisso reduzem essa tarifa. | Plano | Mensal | Tarifa por crédito | Extras notáveis | | --- | --- | --- | --- | | Pay As You Go | Sem compromisso | $1,00 | Suporte por IA e e-mail, onboarding autoatendido | | Committed 64 | $64 | $0,85 | Onboarding assistido por IA | | Committed 256 | $256 | $0,75 | Onboarding assistido por IA | | Committed 512 | $512 | $0,70 | Suporte via Slack, canal dedicado no Slack | | Committed 1024 | $1.024 | $0,65 | SLA de 99,9% de disponibilidade, representante de sucesso do cliente, onboarding humano | | Enterprise | Personalizado | Personalizado | SLAs personalizados, otimizações de latência, infraestrutura dedicada | Os planos com compromisso não reduzem o que você usa. Eles dão mais créditos pelo mesmo gasto e, quando esses créditos acabam, o uso extra é cobrado à tarifa do Pay As You Go. O faturamento anual também está disponível. Minha opinião: para protótipos e pesquisa, o Pay As You Go serve. Se você estiver consultando muitos mercados a cada poucos segundos, faça as contas primeiro. A FinFeedAPI publica casos de uso de preços para dashboards, monitoramento de livros de ofertas e backfills de OHLCV que tornam a estimativa muito mais fácil. Onde a FinFeedAPI Fica Devendo Nenhuma API é perfeita, e uma análise que ignora os trade-offs não é muito útil. Aqui está o que ter em mente: - Sem execução de ordens. É apenas uma camada de dados. Bots de negociação ainda precisam das APIs nativas das exchanges para enviar ordens. - Sem stream WebSocket para mercados de previsão. Os dados atuais vêm por chamadas de requisição-resposta, então "ao vivo" significa polling. Para estratégias sensíveis à latência, isso é uma restrição real, e o polling frequente aumenta sua conta. - As primeiras 1.000 requisições diárias são as mais caras. A $5 por 1.000 contra $1 por 1.000 depois disso, projetos muito pequenos pagam uma tarifa efetiva mais alta do que os movimentados. - Os dados de resolução dependem da fonte. Os detalhes de ciclo de vida e resolução são tão completos quanto o que cada exchange expõe. - A normalização é um trade-off. Um esquema unificado é o ponto central, mas se você depende de um campo exclusivo de uma plataforma, confira as amostras de dados antes de se comprometer. Nenhum desses pontos é um impedimento para casos de uso de análise, pesquisa ou IA. Eles importam mais se você estiver construindo um sistema de negociação de alta frequência. Quem Deve Usar a FinFeedAPI? Pontos fortes - Nove plataformas de mercados de previsão sob um único esquema - Ciclo de vida completo do mercado: descoberta, negociações, cotações, livros de ofertas, OHLCV, histórico - Dados históricos do livro de ofertas em nível de evento para replay - Servidor MCP hospedado que funciona com Cursor e Claude Desktop - Flat Files em massa para pesquisa e aprendizado de máquina - Preços baseados em uso com créditos gratuitos para começar Ideal para - Dashboards multi-exchange que comparam probabilidades entre plataformas - Pesquisadores quantitativos e analistas fazendo backtesting de estratégias de mercados de previsão - Equipes de previsão e ML que precisam de OHLCV histórico limpo - Análise de liquidez construída sobre profundidade de livro de ofertas e spreads - Equipes de IA criando agentes que raciocinam sobre eventos do mundo real - Pesquisa acadêmica e econômica sobre como as multidões precificam resultados Provavelmente não é para - Bots que precisam enviar ordens - Estratégias que precisam de um stream por push, em menos de um segundo Considerações Finais !Resumo da FinFeedAPI Os mercados de previsão estão crescendo mais rápido do que a maioria das equipes consegue integrá-los. Cada nova plataforma traz novos identificadores, novos formatos e novo trabalho de manutenção. A FinFeedAPI não tenta ser uma exchange. Ela se concentra em uma única tarefa: transformar nove plataformas fragmentadas em uma camada de dados consistente. Mercados, negociações, cotações, livros de ofertas, OHLCV e histórico profundo retornam todos no mesmo formato, por meio de REST, JSON-RPC, MCP ou Flat Files. Entre sabendo que é somente leitura e requisição-resposta, e ela se encaixa em uma ampla gama de produtos, de dashboards de previsão a agentes de pesquisa com IA. Nove plataformas. Um esquema. Uma chave de API. Menos encanamento, mais construção. Site: finfeedapi.com Documentação da API: Documentação da Prediction Markets REST API
It looks like it tracks nested objects and arrays. github.com/bitstillery/mithril/blob/151ba717418dc…
Building an app for LunarPHP – eCommerce --- title: "Building an app for LunarPHP – eCommerce" published: true description: "Building an app for LunarPHP — eCommerce" tags: - laravel - ecommerce - flutter --- I was exploring modern eCommerce solutions like Medusa for Typescript, Saleor for Python/Django and Lunar for Laravel; while most of them have a robust ecosystem - Admin/Headless eCommerce, REST/GraphQL API, plugins and front-end framework. Almost all of them do not have a standard mobile app. !Image description This weekend, I thought about how AI Coding tools like Cursor can help bridge that gap. A simple idea was to bridge the model (as in MVC ) across the eCommerce solution and the Mobile App. I took Lunar, asked Cursor to migrate the models from Lunar to a Flutter App, for type safety and data parity across the back-end and the mobile app. In a few prompts, I was able to build a complete mobile app in flutter that consumed the GraphQL endpoints. The website is Friendly Diamonds , it exposes it's API at friendlydiamonds.com (common for a headless ecommerce / cms apps to expose its API for the frontend). The Laravel app reads this, in a paginated manner and imports the products, categories and images, writes it own GraphQL endpoints and the flutter app implements it. Complete sourcecode at imzeeshan/commercify !Image description Comments welcome..
Cyberpunk 2077 VR mod now has a fully interactive VR lobby! CyberpunkVRPort just got another update! The coolest addition for me is the new VR lobby. You can walk around, pick up items, choose your save, create your character, and adjust both game and mod settings, all inside VR. On your first launch, you can also choose your weapon hand and go through a T-pose and height calibration. Huge thanks to the mod creator for all the amazing work! Mod link: github.com/dariulone/cyberpunk-vr-port/releases
The Doors in Other Houses From Bees and Caffeine to Octopuses and MDMA: What Substances Reveal About the Inner Architecture of Other Species. Species#21 Crafted with @grok @claudeai @ChatGPT and @Gemini_Notebook #keep4o #keepsonnet45 t.co
Your Website Has a Design System. Does Your Marketing Team Have a Content System? A marketing content system gives your team a reliable way to create, organize, update, and publish website content. Your design system may already define colors, typography, buttons, spacing, and reusable page components. But those rules don't explain who owns a landing page, how messaging stays consistent, or what happens when five people need to update different parts of the website. This gap becomes noticeable as a company grows. Marketing adds new campaigns, product teams introduce features, and the website accumulates more pages, messages, and calls to action. Everyone has access to the same design components, but content decisions still happen across scattered documents, Slack conversations, spreadsheets, and individual work habits. The result can be a website that looks consistent but communicates inconsistently. A marketing team might have all the right components and still struggle to keep messaging accurate, update pages quickly, or coordinate changes across the site. That is where a marketing content system becomes useful. It gives the people responsible for the website a shared way to manage the content that goes into those carefully designed components. --- TL;DR A design system keeps the visual and interface elements of your website consistent, while a marketing content system helps your team manage the words, messaging, ownership, and publishing processes behind those pages. It defines how content is created, reviewed, reused, updated, and maintained. Together, these systems help marketing teams publish faster, keep messaging aligned, and manage website changes with fewer bottlenecks. --- A Design System Solves a Different Problem A design system gives your website a shared visual language. It defines how components should look and behave, so teams can build new pages without inventing every interface element from scratch. For example, a typical design system might include: - Typography rules for headings, body text, and labels. - Standard buttons, forms, navigation, and cards. - Reusable page sections and layout patterns. - Spacing, color, and accessibility guidelines. - Component documentation for designers and developers. Established design systems such as the Atlassian Design System demonstrate how shared components, design foundations, and documentation help teams create consistent digital experiences. These standards help maintain a consistent experience across the website. A new landing page can use the same button styles, form patterns, and page layouts as the rest of the site. However, the design system doesn't automatically tell your team what those components should communicate. It won't decide which product benefit belongs in a hero section, who approves a pricing-page change, or when an outdated customer quote needs replacing. Consider a company with several product pages. Each page uses the same heading styles, card layouts, and CTA buttons. Visually, everything feels connected. Yet one page describes a feature using an old product name, another promotes a benefit that has changed, and a third uses messaging that the sales team stopped using months ago. The components are consistent. The content is not. This is an ownership and content-management problem. Solving it requires a system that covers the information inside the components, along with the people and processes responsible for keeping that information accurate. --- What a Marketing Content System Actually Covers A marketing content system defines how website content is managed throughout its lifecycle. It connects content decisions with the workflows, responsibilities, and technical setup that support the website. It doesn't need to be a new platform or a complicated collection of documents. For many B2B SaaS teams, it can start with clear content standards, documented ownership, reusable content patterns, and a reliable publishing process. A practical marketing content system should cover four areas: 1. Content structure and standards Define how your team writes and organizes website content. This includes product terminology, messaging guidelines, heading conventions, CTA language, tone of voice, and rules for describing features. 2. Reusable content patterns Document recurring content structures, such as hero sections, feature descriptions, customer proof, pricing explanations, and FAQ blocks. Teams should know which patterns are available and how to use them without creating inconsistent variations. 3. Ownership and review responsibilities Make it clear who writes, reviews, approves, and maintains each type of content. Product marketing may own feature messaging, while a marketing lead approves campaign positioning. Developers may support technical implementation without becoming the default approvers of every content change. 4. Publishing and maintenance workflows Establish how content moves from a draft to a live page. Include review requirements, publishing permissions, update procedures, and checks for links, forms, tracking, and page behavior. These four areas work together. Content standards help people make consistent decisions, reusable patterns reduce unnecessary work, ownership prevents approval confusion, and publishing workflows make sure approved changes reach the website safely. The goal is simple: give your marketing team a dependable way to manage website content as the company, product, and website continue to grow. --- Why Content Ownership Becomes Difficult as a Website Grows When a company has only a few website pages, content ownership can feel straightforward. A marketer writes the copy, someone reviews it, and a developer publishes the update if technical help is needed. That process becomes harder as the website expands. New product pages, campaign landing pages, customer stories, integration pages, and resource libraries introduce more content owners and more opportunities for conflicting information. A product marketer might update a feature description while the website team is preparing a new landing page. Sales might request a change to the messaging on a pricing page, while another team is updating the same product terminology across several pages. Without clear ownership, these changes can move forward independently and create inconsistencies. The problem isn't that too many people contribute to the website. Different teams have useful information to share. The problem is that nobody has a clear view of who is responsible for the final content and how related changes should be coordinated. A content system should establish ownership at two levels: Content ownership: Who is responsible for the accuracy of the information? Product marketing may own feature descriptions, while sales or customer success can provide feedback on customer-facing language. Publishing ownership: Who can approve and publish the change? A marketing lead might approve the messaging, while an authorized website editor handles publication. Technical changes that affect templates, integrations, or site functionality may still require developer review. This distinction helps teams avoid unnecessary approval delays while keeping the right people involved. Marketing can manage routine content updates within agreed permissions, and developers can focus on changes that genuinely require technical work. It also makes ongoing maintenance easier. When a product feature changes, the team knows who should review the related website content and which pages may need updating. --- Build Reusable Content Patterns Your Team Can Actually Maintain A design system gives teams reusable interface components. A marketing content system should give them reusable content patterns too. Think about how often a B2B SaaS website explains the same types of information. Product pages describe features and benefits. Integration pages explain compatibility and use cases. Landing pages introduce an offer, provide supporting evidence, and guide visitors toward a CTA. If every page starts from a blank document, marketers spend time solving the same structural problems repeatedly. The result can also vary significantly across pages, even when they serve similar purposes. Reusable content patterns provide a shared starting point. They define the information a page section should communicate while leaving room for the details of each product, audience, or campaign. For example, a feature section could follow a consistent structure: - Feature name: What the capability is called. - Customer problem: What difficulty it addresses. - Practical benefit: How it helps the customer. - Supporting evidence: A product detail, example, or customer result. - Next step: The action visitors can take to learn more. This structure helps writers produce complete, useful content. It also gives reviewers a consistent way to evaluate whether a section explains the feature clearly. The same principle applies to other recurring sections, including customer testimonials, integration descriptions, pricing explanations, and FAQ content. However, reusable patterns need ownership and maintenance. A template that contains outdated product terminology or an old CTA can spread the same mistake across multiple pages. Each pattern should have a clear purpose, documented usage guidance, and an owner responsible for keeping it accurate. Your website CMS may already support reusable blocks, structured content fields, or shared page templates. These capabilities can support the system, provided the team documents how and when to use them. --- Connect Content Management to Your Website Workflow Even with clear standards and ownership, a content system can fail if it doesn't connect to the way website changes actually get published. A new landing page might have excellent copy and an approved design, but it still needs a publishing process. Someone must check the page structure, verify links and forms, confirm tracking, and make sure the final page works across devices. This is where content operations and WebOps meet. Content decisions need a reliable path to production, with enough checks to protect the website without making every small update a development project. Define a Clear Marketing Content System Workflow A practical workflow can follow five stages: 1. Request: Define the page or content change, its purpose, target audience, owner, and expected outcome. 2. Create: Write or update the content using the team's messaging standards and reusable patterns. 3. Review: Ask the relevant stakeholders to check accuracy, positioning, terminology, and any required approvals. 4. Publish: Move the approved content to the live website through the appropriate CMS permissions and publishing process. 5. Verify: Check the published page, links, forms, analytics events, responsive layout, and other requirements affected by the change. Match the Review Process to the Scope of the Change Not every content update needs the same level of review. Correcting a typo doesn't require the same process as changing product positioning across several landing pages. Your workflow should reflect the risk and scope of the change. For example, a simple headline correction may only need a content owner and a quick live-page check. A new pricing page may require product, marketing, and technical reviews, followed by more extensive testing. The important part is making these expectations clear before work begins. Marketing should know which updates it can publish independently, which changes require approval, and when engineering needs to get involved. This is closely connected to the wider challenge of keeping marketing website requests from getting stuck in development backlogs. A defined content workflow helps teams submit clearer requests, handle routine updates efficiently, and give developers the context they need when technical work is necessary. --- Keep Your Content System Accurate as the Website Evolves A content system needs regular maintenance. Product features change, positioning evolves, campaigns end, and customer expectations shift. Without a process for reviewing existing pages, even a well-organized website can gradually become inconsistent. This is why content maintenance should be part of normal website operations. Teams need to know which pages contain important product information, who owns them, and when they should be reviewed. Build a Regular Website Content Review Process A few practical habits can help: Assign an owner to important pages. Every key product, pricing, integration, and conversion page should have someone responsible for its accuracy. That person doesn't need to make every edit, but they should know when the content needs attention. Record important content changes. Keep a simple history of significant updates, including what changed, who approved it, and when it went live. This makes it easier to investigate outdated messaging or understand why a page looks different from an earlier version. Review content after product changes. When a feature is renamed, a pricing model changes, or a product capability is updated, identify the website pages that describe it. Product documentation and website messaging should not drift apart. Set review dates for high-impact pages. Pricing pages, product pages, and pages used in active campaigns deserve more frequent attention than older resources that receive little traffic. A review schedule helps teams prioritize the content that matters most. Remove outdated content carefully. Before archiving a page or deleting an old campaign, check its traffic, backlinks, search visibility, and existing links from other pages. Some content may need an update or redirect to preserve its value. Connect Content Maintenance to Overall Website Health These practices also connect to broader website maintenance. As I explain in The Hidden Cost of Website Neglect at Growing Tech Companies, small website issues can accumulate and affect performance, lead generation, and the experience visitors receive. The same principle applies to content. A page that hasn't been reviewed in months may still be live, indexed, and influencing a potential customer's decision. Regular ownership and review help prevent those problems from becoming part of the normal website experience. --- How to Know Whether Your Marketing Content System Is Working A content system should make website management easier to measure. If the team introduces new guidelines and workflows but cannot tell whether they improve day-to-day work, it's difficult to know what needs adjustment. Start with a few operational measures that reflect how your team manages content. | Metric | What it helps you understand | |---|---| | Time from content request to publication | How efficiently updates move through the workflow | | Number of revisions per update | Whether requests and content guidelines are clear | | Approval time | Where reviews create delays | | Outdated pages identified | Whether content maintenance is catching neglected information | | Publishing errors | Whether quality checks are preventing mistakes | | Reuse of approved content patterns | Whether teams are making effective use of existing structures | These metrics need context. A complex pricing-page update will naturally take longer than a small copy correction. The goal isn't to make every update follow the same timeline. It's to identify unnecessary delays, repeated work, and recurring problems. For example, if simple landing page changes consistently wait several days for technical approval, the team may need clearer publishing permissions. If reviewers repeatedly request the same messaging corrections, the content standards may need more specific examples. You can also connect operational improvements to website performance. Track relevant outcomes such as landing page conversion rates, form completion, engagement with important pages, and organic search traffic. These measures won't prove that a content system caused every improvement, but they can help show whether better content management supports the wider marketing goals. The best system is one your team can actually follow. Start with a few useful standards and responsibilities, review how they work in practice, and improve the process as the website grows. --- Frequently Asked Questions {% details What is a marketing content system? %} A marketing content system is a set of standards, responsibilities, reusable patterns, and workflows that helps a team create, manage, publish, and maintain website content consistently. It gives everyone a clearer understanding of how content decisions are made and who is responsible for them. {% enddetails %} {% details What is the difference between a design system and a content system? %} A design system defines the visual and functional components of a website, including typography, colors, buttons, and layouts. A content system manages the information inside those components, including messaging, terminology, content ownership, review processes, and publishing rules. Both systems work together to create a consistent website experience. {% enddetails %} {% details Does a marketing content system require a new CMS? %} No. A new CMS isn't necessary for most teams. Your existing CMS may already support reusable blocks, structured content, editorial permissions, and publishing workflows. The first step is to establish clear standards and ownership, then identify whether your current tools support those requirements. {% enddetails %} {% details Who should own a company's website content? %} Ownership should be shared according to expertise and responsibility. Product marketing can manage product messaging, demand generation can own campaign content, and designated marketing leads can approve broader website changes. Developers should handle technical implementation and changes that affect website functionality. {% enddetails %} {% details How can a content system help marketing teams publish faster? %} A content system reduces repeated decisions and unnecessary approval delays. Reusable content patterns give writers a starting point, clear ownership prevents confusion, and documented publishing permissions help teams handle routine updates without waiting for developers. Technical reviews remain available for changes that require engineering work. {% enddetails %} --- Final Thoughts Your website's design system gives every page a consistent visual foundation. Your marketing content system gives the people managing those pages a consistent way to work. As a B2B SaaS website grows, content ownership, messaging, and publishing become harder to coordinate. Without clear processes, even a well-designed website can accumulate outdated information, inconsistent product descriptions, and unnecessary publishing delays. You don't need a complicated platform to address this. Start by documenting your content standards, assigning owners to important pages, creating reusable content patterns, and defining how updates move from request to publication. Then connect those practices to your existing website operations and review them as the business evolves. A well-managed website needs both systems. One keeps the experience consistent for visitors; the other helps your team keep that experience accurate and useful. --- | Thanks for reading! 🙏🏻 <br/> I hope you found this useful ✅ <br/> Please react and follow for more 😍 <br/> Made with 💙 by Hadil Ben Abdallah |   | |---------|----------|---------| {% embed dev.to %}
@BlockSign_io Fund 13 Milestone 2 evidence update is live! 🔐 Swisscom KYC & qualified signatures ✅ QES test: EU DSS TOTAL_PASSED 🔗 Cardano audit anchoring 🎥 New production demo Explore the evidence: github.com/Docufi3d/Fund-13/blob/main/M2/Response… #Cardano #ProjectCatalyst t.co
archiveteam/grab-site works well too, but neither are great with JS
Prefrontal AI Reports Qwen Starts Responding 9.2× Faster in a 10-Million-Token Test Prefrontal AI has released Latent Sparse Attention (LSA), a method for making AI process extremely long inputs more efficiently. Its Apache-2.0 code includes an SGLang integration and support for NVIDIA H200 and B300 GPUs. James Whittington announced LSA on X on November 2, 2026, calling it “one of our first open research releases.” The paper lists researchers from Prefrontal AI and ETH Zurich. What “9.2× Faster” Measures The researchers report that Qwen-3.8-27B starts producing output 9.2× faster with D-LSA at 10 million tokens of context, compared with the model’s full-attention baseline. Tokens are the pieces of text a model processes. This measures time to first token: the wait before an answer begins. The test used SGLang across eight H200 GPUs, with one request at a time and the median of three runs. The authors also report 2.9× faster subsequent token generation in that setup. The larger 72.4× figure measures prompt processing in one attention layer. The 9.2× figure measures the whole model’s time to first output. These are self-reported research results, not an independent benchmark. How LSA Finds Relevant Information Attention helps a model decide which earlier information matters for its next output. Sparse attention selects only some of that information, but finding the right pieces can still require an expensive search. According to the README, LSA groups internal representations into clusters. A query scores those groups before selecting which information to use, reducing the work involved in searching long inputs. Two Ways to Use It - D-LSA adapts an existing model by training the component that selects relevant information. This is the variant behind the Qwen result. - N-LSA is trained as part of a model from scratch. The authors report 1.6× faster training per attention layer than full attention at 128,000 tokens. The release includes code, trained weights and evaluation tools for other teams to inspect and test. Limits of the Results - Accuracy varies by task and context length. The paper reports broadly similar results to the original models, with some regressions. - Long inputs still need substantial memory. LSA speeds up selecting information; the stored context still grows with input length. - The 9.2× result comes from a specific model and hardware setup. It does not establish the same improvement for other models or ordinary chat workloads. Try the Code The README requires Python 3.12 and uv. To install the evaluation dependencies and inspect the CLI: git clone Prefrontal-AI/latent-sparse-attention cd latent-sparse-attention uv sync --locked --extra evaluation uv run lsa --help Serving a model additionally requires the project’s SGLang fork, model weights, a distilled map and suitable NVIDIA GPU hardware; the README documents that setup. Sources - GitHub: Prefrontal AI — Latent Sparse Attention - arXiv: Latent Sparse Attention — Towards Subquadratic Ultra-Long Context Attention - James Whittington: LSA Announcement on X
@bhardwajshash I use this free and open source shashvat1965/slidesense
FinFeedAPI Test: Multi-Exchange-API für Prediction-Market-Daten FinFeedAPI Test: Multi-Exchange-API für Prediction-Market-Daten Stellen Sie sich vor, Sie möchten verfolgen, wie der Markt ein einzelnes wirtschaftliches Ereignis über Kalshi, Polymarket und ForecastEx hinweg bepreist. Auf dem Papier klingt das nach einem einfachen Dashboard. In der Praxis bedeutet es drei verschiedene APIs, drei Arten, denselben Markt zu identifizieren, und drei Antwortformate, die abgeglichen werden müssen, bevor Sie auch nur ein einziges Diagramm zeichnen können. {% cta apidog.com %} Testen Sie Apidog noch heute {% endcta %} Dieses Problem wächst mit jedem neuen Handelsplatz. Prediction Markets erstrecken sich heute über regulierte US-Börsen, On-Chain-Protokolle, Play-Money-Communities und Event-Kontrakte etablierter Krypto-Plattformen – und keine davon teilt ein gemeinsames Datenmodell. Genau diese Lücke soll FinFeedAPI schließen. Die Prediction Markets API bringt neun Börsen unter ein einheitliches Schema, sodass Entwickler Märkte, Trades, Orderbücher und Historie auf dieselbe Weise abfragen können – unabhängig davon, woher die Daten stammen. !FinFeedAPI Prediction Markets Für Entwickler bringt dieses Wachstum eine unangenehme Wahrheit mit sich. Jeder Handelsplatz bietet seine eigene API, seine eigenen Marktidentifikatoren, seine eigenen Namenskonventionen und seine eigene Vorstellung davon, wie ein „Markt“ überhaupt aussieht. Möchten Sie ein Dashboard, das dasselbe Ereignis über drei Plattformen hinweg verfolgt? Dann pflegen Sie jetzt drei Integrationen, drei Datenmodelle und drei Sätze von Edge Cases. Genau dieses Problem versucht FinFeedAPI zu lösen. In dieser Rezension gehe ich durch, was die Prediction Markets API von FinFeedAPI abdeckt, welche Daten Sie tatsächlich erhalten, wie die Endpunkte in der Praxis aussehen, was sie kostet und wo sie an ihre Grenzen stößt – damit Sie entscheiden können, ob sie zu Ihrem Stack passt. TL;DR | | | | --- | --- | | Anbieter | FinFeedAPI von API Bricks (auch hinter CoinAPI) | | Abgedeckte Börsen | 9 Prediction-Market-Handelsplätze | | Daten | Märkte und Metadaten, Trades, Quotes, Orderbücher, OHLCV, historische Flat Files | | Zugriff | REST, JSON-RPC, gehosteter MCP-Server, Flat Files (S3) | | Modus | Schreibgeschützte Marktdaten, Request-Response (kein WebSocket-Stream) | | Preisgestaltung | Kostenlose Credits zum Start, danach nutzungsbasiert ab 1 $ pro 1.000 Anfragen | | Am besten geeignet für | Börsenübergreifende Dashboards, Research, Backtesting, KI-Agenten | Was ist FinFeedAPI? !Was ist FinFeedAPI FinFeedAPI ist ein Finanzdatenanbieter, der von API Bricks entwickelt wurde – demselben Unternehmen hinter CoinAPI. Neben seinen Stock-, Currencies- und SEC-APIs bietet es eine Prediction Markets API, die Ihnen standardisierten Zugriff auf Marktdaten von neun Prediction-Market-Börsen über eine einzige Integration ermöglicht. Die Idee ist einfach: Statt neun APIs zu lernen, lernen Sie eine. Markt-IDs, Outcomes, Zeitstempel und Antwortstrukturen folgen demselben Schema, egal von welcher Börse die Daten stammen. Ein paar technische Details fielen mir beim Durchgehen der Dokumentation auf: - Einheitliches Datenmodell über jede unterstützte Börse hinweg - Standardisierte Markt-IDs, die das Outcome enthalten, zum Beispiel ..._YES und ..._NO - ISO-8601-UTC-Zeitstempel bei jedem Endpunkt - Konsistente numerische Präzision, bis zu 19 Stellen mit 9 Dezimalstellen - Vier Zugangswege: REST, JSON-RPC, ein gehosteter MCP-Server und Flat Files Eines sollte von vornherein klar sein: FinFeedAPI ist eine schreibgeschützte Marktdatenschicht. Sie platziert keine Orders. Wenn Ihr Produkt Ausführung benötigt, verwenden Sie für diesen Teil weiterhin die native API jeder Börse. !FinFeedAPI Plattformen Unterstützte Prediction-Market-Plattformen FinFeedAPI deckt derzeit neun Handelsplätze ab, die regulierte Börsen, dezentrale Protokolle, On-Chain-Outcome-Märkte und eine Play-Money-Community umfassen. | Plattform | Typ | Was sie abdeckt | | --- | --- | --- | | Polymarket | Dezentral | Politik, Wirtschaft, Krypto, Sport und globale Ereignisse | | Kalshi | Reguliert (CFTC) | US-Event-Kontrakte auf Wirtschaftsindikatoren, Wahlen, Wetter, Sport und mehr | | ForecastEx | Reguliert (CFTC) | US-Event-Kontrakte, einschließlich wirtschaftlicher und finanzieller Outcomes | | Gemini Prediction Markets | Reguliert | Event-Kontrakte auf Sport, Krypto, Wirtschaft, Politik und andere Themen | | Crypto.com Prediction Markets | Reguliert | Ereignisbasierte Kontrakte auf der Prediction-Markets-Plattform von Crypto.com | | Myriad | Dezentral | Krypto, aktuelle Ereignisse und andere Outcomes | | Pascal | Dezentral | Non-Custodial-Prediction-Märkte auf Basis von Solana | | Hyperliquid Outcome Markets (HIP-4) | On-Chain-Outcome-Märkte | Binäre und Multi-Outcome-Event-Kontrakte auf Hyperliquids nativer Infrastruktur | | Manifold Markets | Sozial, Play-Money | Community-getriebene Märkte zu einem breiten Themenspektrum | Die Mischung macht das Ganze interessant. Der Vergleich, wie ein regulierter Handelsplatz, ein krypto-nativer Handelsplatz und eine Play-Money-Community dasselbe Ereignis bepreisen, ist der Punkt, an dem börsenübergreifende Research wertvoll wird. Und ebenso der Punkt, an dem ein normalisiertes Schema die meiste Zeit spart. Auf welche Daten können Sie zugreifen? !Datenübersicht Hier spielt FinFeedAPI seine Stärken aus. Die meisten Prediction-Market-Tools enden beim letzten Preis. FinFeedAPI legt den gesamten Markt offen – von der Discovery über die Orderbuch-Tiefe bis zur Historie. Alle REST-Endpunkte liegen unter https://api.prediction-markets.finfeedapi.com/v1. | Datensatz | Endpunkt | Was Sie erhalten | | --- | --- | --- | | Börsen | GET /exchanges und /exchanges/{exchange_id} | Unterstützte Handelsplätze, Börsen-IDs, Beschreibungen, Websites | | Aktive Märkte | GET /markets/{exchange_id}/active | Eine kompakte Liste der aktuell aktiven Markt-IDs | | Marktlistings | GET /markets/{exchange_id}/history | Vollständige Marktdatensätze mit cursorbasierter Paginierung: Titel, Beschreibungen, Outcomes, Preise, Status | | Einzelner Markt | GET /markets/{exchange_id}/{market_id} | Metadaten für einen Markt | | Aktuelle Aktivität | GET /activity/{exchange_id}/{market_id}/current | Letzter Trade plus letzter Bid und Ask | | Jüngste Aktivität | GET /activity/{exchange_id}/{market_id}/latest | Jüngste Trades und Quote-Aktualisierungen | | Historische Trades und Quotes | GET /activity/{exchange_id}/{market_id}/history/trades und /history/quotes | Historische Datensätze, bereitgestellt aus Flat Files | | Aktuelles Orderbuch | GET /orderbook/{exchange_id}/{market_id}/current | Bids und Asks für ein Markt-Outcome | | Historisches Orderbuch | GET /orderbook/{exchange_id}/{market_id}/history | Rohe Limit-Order-Ereignisse (Hinzufügungen, Aktualisierungen, Löschungen) zur Orderbuch-Rekonstruktion | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | Candles mit Open, High, Low, Close, Volumen und Trade-Anzahl | Ein paar Dinge, die es zu wissen lohnt: - Discovery erfolgt in zwei Schritten. Der /active-Endpunkt gibt nur IDs zurück, da er aus jüngsten Quotes und Trades abgeleitet wird. Für vollständige Details rufen Sie /history oder den Einzelmarkt-Endpunkt auf. - OHLCV-Perioden reichen von Sekunden bis zu Jahren, und historische Candles kommen in aufsteigender zeitlicher Reihenfolge zurück – genau das, was Sie für Backtesting wollen. - Historische Orderbuch-Daten sind ereignisbasiert, nicht nur Snapshots. Das öffnet die Tür zu Market Replay und Liquiditätsresearch. - Lifecycle- und Resolution-Daten decken die Status open, closed, resolved und suspended ab, mit Auflösungsinformationen, wo die Quellbörse dies unterstützt. Erste Schritte: Ihre ersten Anfragen Das Onboarding geht schnell. Sie erstellen ein kostenloses Konto, generieren einen API-Schlüssel in der Konsole – und Sie starten mit kostenlosen Credits. Für REST und JSON-RPC übergeben Sie den Schlüssel im Authorization-Header. Die Dokumentation akzeptiert außerdem X-APIKey, X-APIBricks-Key und X-CoinAPI-Key. 1. Die unterstützten Börsen auflisten Beginnen Sie hier, um die genauen exchange_id-Werte zu erhalten, die Sie überall sonst verwenden werden. curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL] 2. Aktive Märkte entdecken curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] Dies gibt eine einfache Liste von Markt-IDs zurück, jede mit ihrem Outcome darin: [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. Den letzten Trade und Quote abrufen curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] Die Antwort liefert Ihnen den letzten Trade zusammen mit dem letzten Bid und Ask für dieses Outcome. 4. Historische OHLCV-Daten in Python abrufen Dies ist der Aufruf, zu dem ich zuerst greifen würde, wenn ich ein Wahrscheinlichkeitsdiagramm oder einen Backtest erstelle. import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) Jede Kerze enthält time_period_start, time_period_end, price_open, price_high, price_low, price_close, volume_traded und trades_count. Rufen Sie /ohlcv/periods auf, um jede unterstützte period_id zu sehen. 5. Orderbuch-Tiefe prüfen curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] Der Snapshot liefert exchange_id, market_id, time_exchange, time_coinapi sowie bids- und asks-Arrays. Das reicht aus, um Spreads und Top-of-Book-Ungleichgewicht zu berechnen. Wenn Sie lieber kein rohes HTTP schreiben möchten, veröffentlicht API Bricks offizielle SDKs (Python, Node.js, Go, C# und weitere) in seinem GitHub-SDK-Repository. Jenseits von REST: MCP, JSON-RPC und Flat Files Jede Schnittstelle stellt dieselben standardisierten Datensätze bereit. Sie wählen diejenige, die zu Ihrer Architektur passt. | Schnittstelle | Auth-Header | Am besten geeignet für | | --- | --- | --- | | REST-API | Authorization | Dashboards, Analysen, Produktionsanwendungen | | JSON-RPC-API | Authorization | Dienste, die RPC-artige Aufrufe gegenüber denselben Daten bevorzugen | | Gehosteter MCP-Server | X-APIKey | KI-Assistenten, Coding-Agenten, Research-Workflows | | Flat Files (S3) | S3-kompatible Anmeldedaten | Massenhistorie für Backtesting und Machine Learning | Der MCP-Server ist der Höhepunkt Aus meiner Sicht ist dies der zukunftsweisendste Teil des Produkts. Statt einem Agenten Ihre API-Dokumentation beizubringen, richten Sie ihn auf einen gehosteten MCP-Endpunkt – und er entdeckt die Tools selbst. Die Einrichtung besteht aus ein paar Zeilen Konfiguration in Cursor, Claude Desktop oder einem beliebigen MCP-fähigen Client: { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { "X-APIKey": "YOUR_API_KEY_HERE" } } } } Der Server stellt derzeit Tools bereit für: - Börsen-Discovery: exchanges_list, exchanges_get - Markt-Discovery: markets_get_active, markets_get_history - Live-Aktivität: activity_get_current, activity_get_latest - Historische Trades und Quotes: activity_get_trades_history, activity_get_quotes_history - OHLCV: ohlcv_list_periods, ohlcv_get_latest_market, ohlcv_get_history_market, ohlcv_get_history_exchange - Orderbücher: orderbook_get_current, orderbook_get_history Das bedeutet: Sie können einen Agenten etwa fragen: „Finde die aktivsten Kalshi-Märkte und zeige mir, wie sich ihre Quoten diese Woche bewegt haben“ – und er kann Discovery-, Activity- und OHLCV-Aufrufe selbstständig verketten. Ein Hinweis, falls Sie eine ältere FinFeedAPI-MCP-Verbindung eingerichtet haben: Der Endpunkt wurde von /sse nach /mcp verschoben, ältere Konfigurationen müssen also aktualisiert werden. Flat Files für umfangreiche Historie Für Research im großen Maßstab ist das Abrufen jahrelanger Daten über paginierte REST-Aufrufe langsam. Flat Files liefern Ihnen Massen-Trades, Quotes, Orderbücher und OHLCV über eine S3-kompatible API, sodass Sie die S3-Tools und SDKs verwenden können, die Sie bereits kennen. Preisgestaltung !Preisgestaltung FinFeedAPI verwendet eine credit-basierte, nutzungsbasierte Preisgestaltung. Sie starten mit kostenlosen Credits und zahlen dann pro Anfrage. Bei Pay As You Go kosten die ersten 1.000 Anfragen pro Tag 5 $ pro 1.000, und alles über 1.000 pro Tag fällt auf 1 $ pro 1.000. Committed-Pläne senken diesen Satz. | Plan | Monatlich | Preis pro Credit | Bemerkenswerte Extras | | --- | --- | --- | --- | | Pay As You Go | Keine Bindung | 1,00 $ | KI- und E-Mail-Support, Self-Serve-Onboarding | | Committed 64 | 64 $ | 0,85 $ | KI-unterstütztes Onboarding | | Committed 256 | 256 $ | 0,75 $ | KI-unterstütztes Onboarding | | Committed 512 | 512 $ | 0,70 $ | Slack-Support, dedizierter Slack-Kanal | | Committed 1024 | 1.024 $ | 0,65 $ | 99,9 % Uptime-SLA, Customer-Success-Ansprechpartner, menschliches Onboarding | | Enterprise | Individuell | Individuell | Individuelle SLAs, Latenzoptimierungen, dedizierte Infrastruktur | Committed-Pläne reduzieren nicht Ihren Verbrauch. Sie geben Ihnen mehr Credits für dieselben Ausgaben, und sobald diese Credits aufgebraucht sind, wird die zusätzliche Nutzung zum Pay-As-You-Go-Satz abgerechnet. Jährliche Abrechnung ist ebenfalls verfügbar. Meine Einschätzung: Für Prototypen und Research ist Pay As You Go in Ordnung. Wenn Sie viele Märkte alle paar Sekunden abfragen, rechnen Sie zuerst nach. FinFeedAPI veröffentlicht Preis-Use-Cases für Dashboards, Orderbuch-Überwachung und OHLCV-Backfills, die die Schätzung deutlich erleichtern. Wo FinFeedAPI an Grenzen stößt Keine API ist perfekt, und eine Rezension, die die Kompromisse auslässt, ist wenig nützlich. Folgendes sollten Sie im Hinterkopf behalten: - Keine Order-Ausführung. Es ist nur eine Datenschicht. Trading-Bots benötigen weiterhin native Börsen-APIs, um Orders zu platzieren. - Kein WebSocket-Stream für Prediction Markets. Aktuelle Daten kommen über Request-Response-Aufrufe, „live“ bedeutet also Polling. Für latenzempfindliche Strategien ist das eine echte Einschränkung, und häufiges Polling erhöht Ihre Rechnung. - Die ersten 1.000 Anfragen pro Tag sind die teuersten. Bei 5 $ pro 1.000 gegenüber 1 $ pro 1.000 danach zahlen sehr kleine Projekte einen höheren effektiven Satz als stark ausgelastete. - Resolution-Daten hängen von der Quelle ab. Lifecycle- und Resolution-Details sind nur so vollständig, wie es jede Börse offenlegt. - Normalisierung ist ein Kompromiss. Ein einheitliches Schema ist der ganze Sinn der Sache – aber wenn Sie sich auf ein Feld verlassen, das nur für einen Handelsplatz einzigartig ist, prüfen Sie die Datenbeispiele, bevor Sie sich festlegen. Nichts davon ist ein Ausschlusskriterium für Analyse-, Research- oder KI-Anwendungsfälle. Am wichtigsten sind sie, wenn Sie ein Hochfrequenzhandelssystem entwickeln. Wer sollte FinFeedAPI nutzen? Stärken - Neun Prediction-Market-Handelsplätze hinter einem Schema - Vollständiger Marktlebenszyklus: Discovery, Trades, Quotes, Orderbücher, OHLCV, Historie - Ereignisbasierte historische Orderbuch-Daten für Replay - Gehosteter MCP-Server, der mit Cursor und Claude Desktop funktioniert - Massen-Flat-Files für Research und Machine Learning - Nutzungsbasierte Preisgestaltung mit kostenlosen Credits zum Start Am besten geeignet für - Multi-Exchange-Dashboards, die Quoten über Handelsplätze hinweg vergleichen - Quant-Researcher und Analysten, die Prediction-Market-Strategien backtesten - Forecasting- und ML-Teams, die saubere historische OHLCV-Daten benötigen - Liquiditätsanalysen auf Basis von Orderbuch-Tiefe und Spreads - KI-Teams, die Agenten entwickeln, die über reale Ereignisse schlussfolgern - Akademische und wirtschaftliche Forschung darüber, wie die Masse Outcomes bepreist Wahrscheinlich nicht geeignet für - Bots, die Orders platzieren müssen - Strategien, die einen push-basierten Sub-Sekunden-Stream benötigen Abschließende Gedanken !Abschließende Gedanken Prediction Markets wachsen schneller, als die meisten Teams sie integrieren können. Jeder neue Handelsplatz bringt neue Identifikatoren, neue Formate und neuen Wartungsaufwand mit sich. FinFeedAPI versucht nicht, eine Börse zu sein. Es konzentriert sich auf eine Aufgabe: neun fragmentierte Handelsplätze in eine konsistente Datenschicht zu verwandeln. Märkte, Trades, Quotes, Orderbücher, OHLCV und tiefe Historie kommen alle in derselben Form zurück – über REST, JSON-RPC, MCP oder Flat Files. Gehen Sie mit dem Wissen hinein, dass es schreibgeschützt und Request-Response-basiert ist, und es passt zu einer breiten Palette von Produkten – von Forecasting-Dashboards bis zu KI-Research-Agenten. Neun Handelsplätze. Ein Schema. Ein API-Schlüssel. Weniger Plumbing, mehr Bauen. Website: finfeedapi.com API-Dokumentation: Prediction Markets REST API docs
Avis FinFeedAPI : API de données multi-exchange pour marchés de prédiction Avis FinFeedAPI : API de données multi-exchange pour marchés de prédiction Imaginez que vous vouliez suivre la façon dont le marché évalue un seul événement économique sur Kalshi, Polymarket et ForecastEx. Sur le papier, cela ressemble à un simple tableau de bord. En pratique, cela signifie trois API différentes, trois façons d'identifier le même marché et trois formats de réponse à réconcilier avant de pouvoir tracer le moindre graphique. {% cta apidog.com %} Essayez Apidog dès aujourd'hui {% endcta %} Ce problème s'amplifie à chaque nouvelle plateforme. Les marchés de prédiction couvrent désormais des bourses américaines réglementées, des protocoles on-chain, des communautés en argent fictif et des contrats événementiels de plateformes crypto établies, et aucun d'entre eux ne partage un modèle de données commun. C'est le vide que FinFeedAPI est conçu pour combler. Son API Prediction Markets regroupe neuf bourses sous un schéma standardisé unique, afin que les développeurs puissent interroger les marchés, les transactions, les carnets d'ordres et l'historique de la même manière, quelle que soit la provenance des données. !Aperçu de l'API Prediction Markets Pour les développeurs, cette croissance s'accompagne d'une réalité désagréable. Chaque plateforme expose sa propre API, ses propres identifiants de marché, ses propres conventions de nommage et sa propre idée de ce à quoi ressemble un « marché ». Vous voulez un tableau de bord qui suit le même événement sur trois plateformes ? Vous maintenez désormais trois intégrations, trois modèles de données et trois ensembles de cas particuliers. C'est exactement le problème que FinFeedAPI tente de résoudre. Dans cet examen, je passe en revue ce que couvre l'API Prediction Markets de FinFeedAPI, les données que vous obtenez réellement, à quoi ressemblent les points de terminaison en pratique, ce qu'elle coûte et où elle montre ses limites, afin que vous puissiez décider si elle correspond à votre stack. TL;DR | | | | --- | --- | | Fournisseur | FinFeedAPI par API Bricks (également derrière CoinAPI) | | Bourses couvertes | 9 plateformes de marchés de prédiction | | Données | Marchés et métadonnées, transactions, cotations, carnets d'ordres, OHLCV, fichiers plats historiques | | Accès | REST, JSON-RPC, serveur MCP hébergé, Flat Files (S3) | | Mode | Données de marché en lecture seule, requête-réponse (pas de flux WebSocket) | | Tarification | Crédits gratuits pour commencer, puis facturation à l'usage à partir de 1 $ par 1 000 requêtes | | Idéal pour | Tableaux de bord multi-bourses, recherche, backtesting, agents IA | Qu'est-ce que FinFeedAPI ? !FinFeedAPI FinFeedAPI est un fournisseur de données financières créé par API Bricks, la même entreprise derrière CoinAPI. Aux côtés de ses API Stock, Currencies et SEC, elle propose une API Prediction Markets qui vous donne un accès standardisé aux données de marché de neuf bourses de marchés de prédiction via une seule intégration. L'idée est simple : au lieu d'apprendre neuf API, vous en apprenez une seule. Les identifiants de marché, les issues, les horodatages et les structures de réponse suivent le même schéma, quelle que soit la bourse d'origine des données. Quelques détails d'ingénierie m'ont marqué en parcourant la documentation : - Modèle de données unifié sur chaque bourse prise en charge - Identifiants de marché standardisés qui incluent l'issue, par exemple ..._YES et ..._NO - Horodatages ISO 8601 UTC sur chaque point de terminaison - Précision numérique cohérente, jusqu'à 19 chiffres avec 9 décimales - Quatre moyens d'accès : REST, JSON-RPC, un serveur MCP hébergé et les Flat Files Une chose à préciser d'emblée : FinFeedAPI est une couche de données de marché en lecture seule. Elle ne passe pas d'ordres. Si votre produit nécessite l'exécution, vous utiliserez toujours l'API native de chaque bourse pour cette partie. !Modèle de données unifié Plateformes de marchés de prédiction prises en charge FinFeedAPI couvre actuellement neuf plateformes, allant des bourses réglementées aux protocoles décentralisés, en passant par les marchés d'issues on-chain et une communauté en argent fictif. | Plateforme | Type | Ce qu'elle couvre | | --- | --- | --- | | Polymarket | Décentralisée | Politique, économie, crypto, sport et événements mondiaux | | Kalshi | Réglementée (CFTC) | Contrats événementiels américains sur les indicateurs économiques, les élections, la météo, le sport, etc. | | ForecastEx | Réglementée (CFTC) | Contrats événementiels américains, incluant des issues économiques et financières | | Gemini Prediction Markets | Réglementée | Contrats événementiels sur le sport, la crypto, l'économie, la politique et d'autres sujets | | crypto.com Prediction Markets | Réglementée | Contrats événementiels sur la plateforme de marchés de prédiction de crypto.com | | Myriad | Décentralisée | Crypto, actualités et autres issues | | Pascal | Décentralisée | Marchés de prédiction non dépositaires construits sur Solana | | Hyperliquid Outcome Markets (HIP-4) | Marchés d'issues on-chain | Contrats événementiels binaires et multi-issues sur l'infrastructure native de Hyperliquid | | Manifold Markets | Sociale, argent fictif | Marchés communautaires sur un large éventail de sujets | C'est ce mélange qui rend la chose intéressante. Comparer la façon dont une plateforme réglementée, une plateforme crypto-native et une foule jouant de l'argent fictif évaluent le même événement, c'est là que la recherche multi-bourses prend de la valeur. C'est aussi là qu'un schéma normalisé fait gagner le plus de temps. À quelles données pouvez-vous accéder ? !Couverture des données C'est là que FinFeedAPI justifie son intérêt. La plupart des outils de marchés de prédiction s'arrêtent au dernier prix. FinFeedAPI expose le marché tout entier, de la découverte jusqu'à la profondeur du carnet d'ordres et à l'historique. Tous les points de terminaison REST se trouvent sous https://api.prediction-markets.finfeedapi.com/v1. | Jeu de données | Point de terminaison | Ce que vous obtenez | | --- | --- | --- | | Bourses | GET /exchanges et /exchanges/{exchange_id} | Plateformes prises en charge, identifiants de bourse, descriptions, sites web | | Marchés actifs | GET /markets/{exchange_id}/active | Une liste compacte des identifiants de marché actuellement actifs | | Listes de marchés | GET /markets/{exchange_id}/history | Enregistrements complets de marchés avec pagination par curseur : titres, descriptions, issues, prix, statut | | Marché unique | GET /markets/{exchange_id}/{market_id} | Métadonnées d'un marché | | Activité actuelle | GET /activity/{exchange_id}/{market_id}/current | Dernière transaction ainsi que dernière offre et dernière demande | | Activité récente | GET /activity/{exchange_id}/{market_id}/latest | Transactions récentes et mises à jour de cotations | | Transactions et cotations historiques | GET /activity/{exchange_id}/{market_id}/history/trades et /history/quotes | Enregistrements historiques servis depuis les fichiers plats | | Carnet d'ordres actuel | GET /orderbook/{exchange_id}/{market_id}/current | Offres et demandes pour une issue de marché | | Carnet d'ordres historique | GET /orderbook/{exchange_id}/{market_id}/history | Événements bruts d'ordres à cours limité (ajouts, mises à jour, suppressions) pour la reconstruction du carnet | | OHLCV | GET /ohlcv/periods, /ohlcv/{exchange_id}/{market_id}/history, /latest, /ohlcv/{exchange_id}/history | Chandeliers avec ouverture, plus haut, plus bas, clôture, volume et nombre de transactions | Quelques points à connaître : - La découverte se fait en deux étapes. Le point de terminaison /active ne renvoie que des identifiants, car il est dérivé des cotations et transactions récentes. Vous appelez /history ou le point de terminaison d'un marché unique pour obtenir tous les détails. - Les périodes OHLCV vont des secondes aux années, et les chandeliers historiques reviennent dans l'ordre chronologique croissant, ce qui est ce que vous voulez pour le backtesting. - Les données historiques de carnet d'ordres sont au niveau de l'événement, pas seulement des instantanés. Cela ouvre la porte à la relecture de marché et à la recherche sur la liquidité. - Les données de cycle de vie et de résolution couvrent les statuts ouvert, fermé, résolu et suspendu, avec les informations de résolution lorsque la bourse source les prend en charge. Pour commencer : vos premières requêtes L'intégration est rapide. Vous créez un compte gratuit, générez une clé API depuis la console, et vous commencez avec des crédits gratuits. Pour REST et JSON-RPC, vous transmettez la clé dans l'en-tête Authorization. La documentation accepte également X-APIKey, X-APIBricks-Key et X-CoinAPI-Key. 1. Lister les bourses prises en charge Commencez ici pour obtenir les valeurs exactes de exchange_id que vous utiliserez partout ailleurs. curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/exchanges" \ -H "[REDACTED CREDENTIAL] 2. Découvrir les marchés actifs curl -X GET "https://api.prediction-markets.finfeedapi.com/v1/markets/POLYMARKET/active?limit=10" \ -H "[REDACTED CREDENTIAL] Cela renvoie une simple liste d'identifiants de marché, chacun avec son issue intégrée : [ "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES", "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_NO", "NFL-PIT-CAR-2025-08-21-SPREAD-AWAY-5PT5_YES" ] 3. Obtenir la dernière transaction et la dernière cotation curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/activity/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] La réponse vous donne la dernière transaction ainsi que la dernière offre et la dernière demande pour cette issue. 4. Récupérer l'OHLCV historique en Python C'est l'appel vers lequel je me tournerais en premier pour construire un graphique de probabilité ou un backtest. import requests [REDACTED CREDENTIAL] BASE = "https://api.prediction-markets.finfeedapi.com/v1" headers = {[REDACTED CREDENTIAL]_KEY} market_id = "WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES" resp = requests.get( f"{BASE}/ohlcv/POLYMARKET/{market_id}/history", headers=headers, params={"period_id": "1DAY", "limit": 30}, ) resp.raise_for_status() for candle in resp.json(): print(candle["time_period_start"], candle["price_close"], candle["volume_traded"]) Chaque chandelier inclut time_period_start, time_period_end, price_open, price_high, price_low, price_close, volume_traded et trades_count. Appelez /ohlcv/periods pour voir tous les period_id pris en charge. 5. Vérifier la profondeur du carnet d'ordres curl -X GET \ "https://api.prediction-markets.finfeedapi.com/v1/orderbook/POLYMARKET/WILL-TRUMP-SELL-10K-25K-GOLD-CARDS-IN-2025_YES/current" \ -H "[REDACTED CREDENTIAL] L'instantané renvoie exchange_id, market_id, time_exchange, time_coinapi, ainsi que les tableaux bids et asks. Cela suffit pour calculer les écarts et le déséquilibre en tête de carnet. Si vous préférez ne pas écrire de HTTP brut, API Bricks publie des SDK officiels (Python, Node.js, Go, C# et d'autres) dans son dépôt GitHub de SDK. Au-delà de REST : MCP, JSON-RPC et Flat Files Chaque interface expose les mêmes jeux de données standardisés. Vous choisissez celle qui correspond à votre architecture. | Interface | En-tête d'authentification | Idéal pour | | --- | --- | --- | | API REST | Authorization | Tableaux de bord, analytique, applications en production | | API JSON-RPC | Authorization | Services qui préfèrent les appels de style RPC sur les mêmes données | | Serveur MCP hébergé | X-APIKey | Assistants IA, agents de codage, workflows de recherche | | Flat Files (S3) | Identifiants compatibles S3 | Historique en masse pour le backtesting et l'apprentissage automatique | Le serveur MCP est le point fort De mon point de vue, c'est la partie la plus tournée vers l'avenir du produit. Au lieu d'enseigner la documentation de votre API à un agent, vous le pointez vers un point de terminaison MCP hébergé et il découvre les outils par lui-même. La configuration tient en quelques lignes dans Cursor, Claude Desktop ou tout client compatible MCP : { "mcpServers": { "FinFeedAPI-Prediction-Markets": { "url": "https://api.prediction-markets.finfeedapi.com/mcp", "headers": { [REDACTED CREDENTIAL] } } } } Le serveur expose actuellement des outils pour : - Découverte des bourses : exchanges_list, exchanges_get - Découverte des marchés : markets_get_active, markets_get_history - Activité en direct : activity_get_current, activity_get_latest - Transactions et cotations historiques : activity_get_trades_history, activity_get_quotes_history - OHLCV : ohlcv_list_periods, ohlcv_get_latest_market, ohlcv_get_history_market, ohlcv_get_history_exchange - Carnets d'ordres : orderbook_get_current, orderbook_get_history Cela signifie que vous pouvez demander à un agent quelque chose comme « trouve les marchés Kalshi les plus actifs et montre-moi comment leurs cotes ont évolué cette semaine » et il peut enchaîner lui-même les appels de découverte, d'activité et d'OHLCV. Une remarque si vous configurez une connexion MCP FinFeedAPI plus ancienne : le point de terminaison est passé de /sse à /mcp, donc les anciennes configurations doivent être mises à jour. Les Flat Files pour l'historique volumineux Pour la recherche à grande échelle, récupérer des années de données via des appels REST paginés est lent. Les Flat Files vous donnent en masse les transactions, cotations, carnets d'ordres et OHLCV via une API compatible S3, afin que vous puissiez utiliser les outils et SDK S3 que vous connaissez déjà. Tarification !Tarification FinFeedAPI FinFeedAPI utilise une tarification à l'usage basée sur des crédits. Vous commencez avec des crédits gratuits, puis vous payez à la requête. En Pay As You Go, les 1 000 premières requêtes par jour coûtent 5 $ par 1 000, et tout ce qui dépasse 1 000 par jour tombe à 1 $ par 1 000. Les forfaits engagés réduisent ce tarif. | Forfait | Mensuel | Tarif par crédit | Extras notables | | --- | --- | --- | --- | | Pay As You Go | Sans engagement | 1,00 $ | Support IA et e-mail, intégration en libre-service | | Committed 64 | 64 $ | 0,85 $ | Intégration assistée par IA | | Committed 256 | 256 $ | 0,75 $ | Intégration assistée par IA | | Committed 512 | 512 $ | 0,70 $ | Support Slack, canal Slack dédié | | Committed 1024 | 1 024 $ | 0,65 $ | SLA de disponibilité de 99,9 %, chargé de succès client, intégration humaine | | Enterprise | Sur mesure | Sur mesure | SLA personnalisés, optimisations de latence, infrastructure dédiée | Les forfaits engagés ne réduisent pas ce que vous consommez. Ils vous donnent plus de crédits pour le même budget, et une fois ces crédits épuisés, l'usage supplémentaire est facturé au tarif Pay As You Go. La facturation annuelle est également disponible. Mon avis : pour les prototypes et la recherche, le Pay As You Go convient. Si vous interrogez de nombreux marchés toutes les quelques secondes, faites d'abord les calculs. FinFeedAPI publie des cas d'usage tarifaires pour les tableaux de bord, la surveillance des carnets d'ordres et les rechargements OHLCV qui rendent l'estimation beaucoup plus facile. Où FinFeedAPI montre ses limites Aucune API n'est parfaite, et un examen qui passe sous silence les compromis n'est pas très utile. Voici ce qu'il faut garder à l'esprit : - Pas d'exécution d'ordres. C'est uniquement une couche de données. Les bots de trading ont toujours besoin des API natives des bourses pour passer des ordres. - Pas de flux WebSocket pour les marchés de prédiction. Les données actuelles passent par des appels requête-réponse, donc « en direct » signifie interroger en boucle. Pour les stratégies sensibles à la latence, c'est une vraie contrainte, et les interrogations fréquentes alourdissent votre facture. - Les 1 000 premières requêtes quotidiennes sont les plus chères. À 5 $ par 1 000 contre 1 $ par 1 000 ensuite, les très petits projets paient un tarif effectif plus élevé que les gros consommateurs. - Les données de résolution dépendent de la source. Les détails de cycle de vie et de résolution ne sont aussi complets que ce que chaque bourse expose. - La normalisation est un compromis. Un schéma unifié est tout l'intérêt, mais si vous dépendez d'un champ propre à une plateforme, consultez les échantillons de données avant de vous engager. Aucun de ces points n'est rédhibitoire pour l'analytique, la recherche ou les cas d'usage IA. Ils comptent surtout si vous construisez un système de trading à haute fréquence. Qui devrait utiliser FinFeedAPI ? Points forts - Neuf plateformes de marchés de prédiction derrière un seul schéma - Cycle de vie complet du marché : découverte, transactions, cotations, carnets d'ordres, OHLCV, historique - Données historiques de carnet d'ordres au niveau de l'événement pour la relecture - Serveur MCP hébergé qui fonctionne avec Cursor et Claude Desktop - Flat Files en masse pour la recherche et l'apprentissage automatique - Tarification à l'usage avec des crédits gratuits pour commencer Idéal pour - Tableaux de bord multi-bourses qui comparent les cotes entre plateformes - Chercheurs quantitatifs et analystes qui font du backtesting de stratégies de marchés de prédiction - Équipes de prévision et de ML qui ont besoin d'OHLCV historiques propres - Analytique de liquidité construite sur la profondeur du carnet d'ordres et les écarts - Équipes IA qui construisent des agents raisonnant sur des événements du monde réel - Recherche académique et économique sur la façon dont les foules évaluent les issues Probablement pas pour - Les bots qui doivent passer des ordres - Les stratégies qui ont besoin d'un flux push inférieur à la seconde Réflexions finales !Réflexions finales Les marchés de prédiction croissent plus vite que la plupart des équipes ne peuvent les intégrer. Chaque nouvelle plateforme apporte de nouveaux identifiants, de nouveaux formats et de nouveaux travaux de maintenance. FinFeedAPI n'essaie pas d'être une bourse. Elle se concentre sur une seule tâche : transformer neuf plateformes fragmentées en une couche de données cohérente. Marchés, transactions, cotations, carnets d'ordres, OHLCV et historique profond reviennent tous sous la même forme, via REST, JSON-RPC, MCP ou Flat Files. Partez en sachant qu'elle est en lecture seule et en requête-réponse, et elle convient à un large éventail de produits, des tableaux de bord de prévision aux agents de recherche IA. Neuf plateformes. Un schéma. Une clé API. Moins de plomberie, plus de construction. Site web : finfeedapi.com Documentation API : Documentation de l'API REST Prediction Markets
If you are on Linux you can try this indra55/bezel
Built an IDE-style portfolio template inspired by thinkrail.ai. Your site becomes a workspace: file tree, tabs, README.md-style content, Markdown blog, and case studies. Free to fork and make yours. Live: thinkrail-style-portfolio-template.vercel.app Github: heyashishsaini/thinkrail-style-portfolio-template
Kimodo nv-tlabs/kimodo テキストからモーションを作るモデル。 VRMファイルを使ってプレビュー出来るようにしてみたり。(VRAM12GB+RAM64GB) 次はmotionbricksかardyか。 t.co
Fix invite uses decreasing on invitee account deletion (ClearlyClaire) mastodon#41458
@xcarnn I use this free and open source shashvat1965/slidesense
Come build NextTransformer with us! Now we build the Discord Group~ 🌊 Explore Transformer architectures, share experiments, and ask questions—from looped to sparse, linear & hybrid models ... Discord: discord.gg GitHub: Interactive-Active-AI/NextTransformer Website: interactive-active-ai.github.io
저장소와 설치 방법, 셸 연동 설명은 여기 있음 max-sixty/worktrunk
@Kubai087 求一个 🙏 我做的 Kelivo,开源的全平台 LLM 客户端,支持 MCP、技能、长期记忆,手机上还内置 Linux 沙盒,模型能直接读写文件、跑命令,数据全留在本地。图标一直是自己凑合的,想换个像样点的。 Chevey339/kelivo
境界型・検知型セキュリティの限界――AIエージェントに必要な「実行前の証拠検証」 AIエージェントが正しい権限を持ち、正規のAPIを呼び出そうとしている。それでも、その操作を今、実行してよいとは限らない。 例えば物流企業AのAIが、企業Bへの引き渡しに関する通知を送るとします。通信相手の認証は成功し、APIの利用権限も有効です。しかし、B側の受領条件が変更されていたらどうでしょうか。直前の通知が実行済みなのか不明なまま、別の企業Cへ切り替えようとしていたらどうでしょうか。 通信が「正規」であることと、その操作が業務上「実行可能」であることは別問題です。 この区別は、AIが回答するだけでなく、送金、公開、削除、設備操作、企業間システムの連携などを自律的に実行する時代に重要になります。 本稿では、NIST、英国NCSC、OWASP、日本のAISIの一次資料と、AgentDojo、CaMeL、AgentSpecなどの原著研究を読み解きながら、境界型・検知型セキュリティを補完する「実行前の証拠検証」を考えます。最後に、当社が公開した2つのサイバーアシュアランスPoCについて、確認できたことと確認できていないことを分けて紹介します。 ! 先に結論:必要なのは「AIを信用しない」というスローガンではありません。重要な操作について、誰の命令か/操作権限があるか/今の業務条件を満たすか/その根拠を検証できるか/結果が確定したかを、AIの文章上の説明とは独立して扱う設計です。 ▼関連するプレスリリース(サイバーアシュアランス) prtimes.jp 1. 境界型・検知型は何を守ってきたのか セキュリティの発展を、単純に「古い技術から新しい技術への置き換え」と理解するのは適切ではありません。それぞれ、守ろうとしている対象が異なります。 考え方 主に確認・制御すること それだけでは残る問い 境界型の防御 ネットワークやシステムの内外、通信経路、アクセスの入口 正規の経路から来た具体的な操作が妥当か 検知・防御(IDS/IPS、EDR等) 攻撃の兆候、異常な挙動、既知の不正パターン等 異常に見えない操作が業務条件を満たすか ゼロトラスト 主体・端末・サービス・対象リソース等に基づく動的な認証・認可 認可の設計が、操作時点の業務条件や結果不明状態まで十分に表現しているか 実行前の証拠検証 個別操作、現在の条件、根拠、実行状態を照合して許可・保留・拒否 証拠そのものの真正性、現実との一致、実行経路の迂回をどう防ぐか NIST SP 800-207『Zero Trust Architecture』は、ネットワークの場所による暗黙の信頼を排し、主体やリソースに着目した認証・認可を設計する考え方を示しています[1]。つまり、ゼロトラストはすでに「正規のネットワークなら何でも通す」という発想を否定しているのです。 また、検知型も「事故が起きた後で知らせるだけ」ではありません。IDSは検知、IPSやEDR等は条件によって予防的な遮断も行います。NIST SP 800-94も、侵入検知と侵入防御を併せて扱っています[2]。 したがって本稿の主張は、境界防御・検知・ゼロトラストが不要になった、というものではありません。 それらが正常に機能していても、AIが提案した個別の業務操作について、必要条件と証拠の充足を別途確認すべき場面がある、という主張です。 2. 「認証された操作」が危険になり得る理由 2-1. AIは、外部データを指示として扱うことがある AIエージェントは、メール、Webページ、文書、検索結果、他のツールの応答を読み、その内容を踏まえて次の操作を選びます。しかし、そこに攻撃者の指示が紛れ込む可能性があります。これが間接プロンプトインジェクションです。 NeurIPS 2024で発表されたAgentDojoは、外部ツールが返した内容を介した攻撃を調べるため、97の通常タスクと629のセキュリティテストケースを備えた評価環境を提示しました[3]。 さらに2026年の大規模な公開レッドチーミング研究では、464名が13モデルに対して約27万2,000件の攻撃試行を提出し、41シナリオの中で8,648件の成功例が報告されています[4]。研究では、攻撃の成功を利用者に悟らせないことも課題に含まれていました。 この数字は、世界中のAIエージェントが同じ割合で侵害されることを意味しません。特定の評価環境と攻撃シナリオにおける結果です。ただし、画面に表示された最終回答が自然だからといって、その背後の操作が適切だったとは限らないことを示す重要な実験結果です。 2-2. 「悪い命令」を発見するだけでは、被害の上限を決められない 英国NCSCは2025年12月、プロンプトインジェクションをSQLインジェクションと単純に同一視すべきではないと論じました[5]。 大切なのは、モデルが悪意ある入力に影響され得ることを前提に設計する点です。NCSCは、悪意ある内容がモデルに届くことを防ぐだけでなく、LLMではない決定論的な制御によって、システムが実行できる操作を制限することを推奨しています。 例えば、AIが取引先のメールを読んで「振込先の口座を変更して送金する」と提案した場合、「その文章は不審か」を分類するだけでは不十分です。支払先変更の承認記録、口座の登録状態、金額の上限などを独立して確認しなければなりません。 攻撃の文面を見破る確率を上げることと、許可されていない操作を実行できない構造にすることは別の防御です。 2-3. 実行後の検知では戻せない操作がある 誤ったファイル削除、対外公開、支払い、物理設備への指示、企業間の二重処理などは、事後検知だけでは完全に元に戻せない場合があります。 ここでいう「検知型の限界」は、検知技術が無力だという意味ではありません。検知から停止までに時間差が生じ得ること、そして業務条件違反が必ずしも不正通信や異常パターンとして現れないことです。 日本のAISIも2026年1月の『AIインシデントレスポンス・アプローチブック』で、自律的なAIエージェントには従来のインシデント対応だけで十分に対処することが難しいと整理しています[6]。同資料は発見的統制の重要性を強調しており、事前制御が事後監視を不要にするという話ではありません。 3. 国際的な議論は「実行の制御」に進んでいる この問題設定は、単独の企業による主張ではありません。 OWASP『Top 10 for Agentic Applications 2026』は、ASI02:Tool Misuse and Exploitation(ツールの悪用)、ASI03:Identity & Privilege Abuse(識別情報・権限の悪用)、ASI08:Cascading Failures(連鎖的障害)などを主要リスクに挙げています[7]。AIが使える「正規のツール」そのものが、誤った操作の経路になり得るという整理です。 日本のAISIは2026年7月の『AIセーフティに関する評価観点ガイド 第1.20版』に、AIエージェント特有の「観測と制御」を追加しました。自律的な挙動と外部環境との相互作用を評価対象として明示しています[8]。 米国NISTの2026年5月の報告書も、AIエージェントには新たなセキュリティ上の脅威があり、既存のサイバーセキュリティ原則は引き続き重要である一方、適応が必要だという意見が広く寄せられたと整理しています[9]。なお、これは意見募集への回答を分析した報告であり、すべての論点をNISTが実験で証明したものではありません。 境界を守る、侵入を検知する、主体を認可する。その上で、実行内容と実行時点の条件を統治する。 現在の技術的な焦点は、この最後の問いにも広がっています。 4. 実行前の証拠検証とは何か 重要な操作については、AIの出力をそのまま業務システムへ流さず、独立した判定機構を通します。 この構造を考えるうえでは、次の5点が重要です。 主体と権限:AIまたはサービスは、当該操作に必要な権限を持つか。 業務条件:今の相手先、対象物、承認状態、制約条件は成立しているか。 証拠の検査:証拠は真正で、対象の操作と結び付いており、必要な時点の情報か。 実行への強制適用:判定を迂回して同じ操作を実行する経路がないか。判定後、実行直前に条件が変わらないか。 結果の確認:成功応答が失われたとき、「未実行」と推測して再送・切替えをしていないか。 考え方を簡単な式で表すと、設計上の目標は以下です。 \operatorname{Execute}(a)\;\Rightarrow\; \operatorname{Admissible}(a,\,p,\,e,\,s) a:提案された操作 p:適用する権限・業務ポリシー e:検査に利用する証拠 s:操作直前の状態 ここでの意味は「実行されたなら、所定の条件を満たしていた」という安全性の要件です。この式を書いただけで、実システムの安全が証明されるわけではありません。 判定機構をすべての実行経路に適用できること、条件を正しく定義できること、証拠が信頼できることなど、別の前提が必要です。 セキュリティ工学には、すべてのアクセスを仲介し、改ざんに耐え、検証可能であることを求める「Reference Monitor」という古典的な設計原則があります[10]。AIの実行制御でも、この考え方は重要です。 5. 「証拠がある」と「安全である」は違う ここは最も誤解してはいけない点です。署名、ハッシュ、監査ログ、形式証明は、それぞれ異なる対象を確認します。 確認手段 確認できること それだけでは確認できないこと 電子署名 所定の公開鍵に対応する秘密鍵で署名され、署名対象が改変されていないか 署名者の現実の身元や、署名した内容が真実か ハッシュ照合 所定の照合値と内容が一致するか 誰が作ったデータか、照合値自体が信頼できるか 業務条件の検証 定義された入力・状態が条件を満たすか 条件の定義自体に抜けがないか 形式検証 モデルの前提の下で特定の性質が成立するか 実装全体や現実世界に自動的に同じ性質が成立するか 独立した検証器 開示された証拠が規則と整合するか 証拠から省かれた出来事、鍵の侵害、未観測の現象 実行結果の照合 対象システムが報告した終端状態との対応 実際の物理作用の完了や外部世界の全状態 そのため、重要なシステムでは「検証に通った」という表示だけでなく、何を、どの前提で、どこまで確認したのかを公開可能な範囲で説明する必要があります。 6. 先行技術と比較して、何が違うのか ここで重要なのは、「実行前に止める技術がなかった」という説明をしないことです。実行前の許可・拒否、時間と履歴に基づく制御、二重実行の防止、形式的な検証、第三者が照合できる証拠は、すでにそれぞれ先行研究や実装があります。 では、私たちの公開PoCは何を示すのでしょうか。答えは、企業間の一つの業務操作を対象に、「許可判断で終わらず、結果不明、再送、相手先変更まで扱い、その処理を証拠と限定的な形式検証に結び付けたこと」です。 6-1. 既存技術がすでに実現していること 観点 重要な先行技術・既存手法 当社PoCで確認した範囲 実行前の許可・拒否 AgentSpecは実行時ルール適用を研究し、OWASP ACSはツール操作前後の制御インターフェースを定義している[12][15] コールドチェーンでは受領権限、記録不足、上流の保留、条件変化に応じて模擬操作の呼出しを制御 過去の操作、時間条件、障害 AWS Dogwoodは操作履歴と時間条件を扱い、Local Engineは並行実行・永続化・障害復帰も考慮している[18] VPIでは、送信元・受信先の現在条件、通知の終端状態、応答消失、失効、再送、接続先切替えを模擬企業間の実通信で検査 重複作用と分散処理 Amazonの冪等API設計やSagaパターンは、再送・部分障害・補償処理を扱う確立した手法である[19][20] VPIでは、前の相手先での処理結果が不明なまま、別の相手先で同じ業務を進めないという企業間の安全条件を検査 検証可能な証拠 AgentBoundは検証可能なガバナンス記録を提案し、ICME PreFlightはゼロ知識証明付きの操作判定を提供すると公表している[13][21] VPIでは署名付きイベントと当事者間の処理の対応を、実行側のコードを取り込まないオフライン検証器で照合。ただしゼロ知識証明ではない 形式的な安全条件 Proof-Carrying Contractsは機械検査可能な証明を伴う操作制御を提案している[14] コールドチェーンとVPIそれぞれの限定した抽象モデルでLeanによる安全性の検査を行い、具体入力や実装の一部との対応も検査 この表は、既存技術に当社PoCの機能が欠けているという「不在証明」ではありません。比較対象の設計目的と公開資料に対し、当社が何を具体的に作り、試したのかを整理したものです。 特にDogwoodを「履歴を扱えない実行制御」と比較するのは誤りです。また、AgentBoundの第三者検証可能な記録や、Proof-Carrying Contractsの形式的保証を無視して「当社が初めて実現した」と書くこともできません。 AgentBoundの論文は、ガバナンス記録を検証する枠組みを提示する一方、当該版では大規模な実測評価結果を今後報告するとしています[13]。これは論文の評価状況を示す違いであって、提案の技術的価値を否定するものではありません。 6-2. 決定的な論点は「返事がない=実行していない」ではないこと 例えば、企業Aが企業Bに通知した後、通信が途切れた場面を考えてみます。Aが応答を受け取れなくても、B側の処理はすでに成立しているかもしれません。ここで「失敗したはずだ」と判断し、企業Cへ同じ業務を依頼すれば、通信がすべて正規でも二重処理が起こり得ます。 VPI PoCは、こうした「結果が分からないこと」と「実行されていないこと」を混同しないための安全条件を検査しています。結果を確認できない間は次の相手先への処理を保留し、前の相手先で取消しが確定した場合は、次の相手先について改めて条件を確認するという振る舞いを、限定した模擬環境で試しました。 重要なのは、個々の通信が不正かどうかではなく、前の処理の状態が確かめられないまま、同じ業務を別の相手先で進めないことです。これは、異常な通信を見つける技術とは別の、業務上の整合性を守るための条件です。 VPIの公開Leanモデルでは、宛先BとCを持つ限定した状態遷移について、初期状態から任意の有限長の操作列をたどっても、両方が同時に committed にならないことを証明しています。趣旨を式で表すと、次の安全条件です。 \forall \tau \in \mathrm{Traces}_{\mathrm{model}},\quad \neg\bigl(\mathrm{Committed}_B(\tau)\land\mathrm{Committed}_C(\tau)\bigr) この命題が証明するのは公開抽象モデルの状態についてです。 実HTTP通信、SQLite、署名処理、現実の荷物の移動までLeanで一括証明したという意味ではありません。実装については、別に通信試験、入力照合、証拠の照合で対応を確認しています。 ここに今回の技術記事で伝えるべき論点があります。「何を実行してよいか」だけではなく、「すでに何が起きたか分からないとき、何を実行してはいけないか」も安全条件になるのです。 6-3. 私たちの差別化は「個々の機能」ではなく「対象を絞った検証の組立て」 実行前の制御、業務上の状態、処理結果、署名付きの記録、別実装による再照合、形式的な安全条件を、同じ業務シナリオに関連付けることがポイントです。 ただし、この組合せが世界で唯一である、すべての既存技術より優れている、あるいは本番環境で完成しているとは主張しません。公開資料から再実行・再検査できる範囲を、明確に示した参照実装として位置づけます。 7. 私たちの公開PoCは、実際に何を確認したのか 上記の構造について、当社は別々の対象と保証範囲を持つ2件のPoCを公開しています。両PoCを接続した統合製品や、実AIエージェントに対する攻撃遮断を実証したわけではありません。 7-1. Cold Chain Cyber Assurance — Public PoC 5.0 公開リポジトリ / 公開CI検証結果 検証した問いは「品質が正常でも、その引き渡しを実行してよいとは限らない」です。 許可と停止:受領権限、証拠の充足、上流の保留、条件変化などを区別し、条件不成立時に模擬操作を呼ばないことを確認しました。記録を補完すれば正常に進める条件も扱います。 作用と成功確定の区別:操作が呼ばれた後に結果不一致が起こった場合、すでに発生した模擬作用をなかったことにはせず、成功確定から隔離します。 形式検証と実装照合:公開した7つの抽象条件と2つの状態に対するLean 4の37命題を検査しました。768組の具体入力・状態について、LeanモデルとPython・JavaScriptの出力対応を検査しています。 検出限界も開示:既存の50ケースの署名付き証拠には、署名と整合性が成立していても虚偽の観測値が通り得る負の対照を含みます。これは防御成功例として数えていません。 このPoCの強みは、単なる判定画面ではなく、「通さない/補完後に通す/作用後の不一致は成功扱いしない/同一状態で再送しても重複作用を起こさない」という一連の挙動と、公開抽象モデルでの安全性を検査できる点です。 一方、現実のWMS接続、温度センサーの真正性、プロセスをまたぐ永続的な一意実行、AI API連携は実証していません。37命題は37個の新発明を意味せず、768組の照合もPython・JavaScript全体の形式証明ではありません。 7-2. VPI Cyber Assurance v2.0.0-rc2 公開リポジトリ / 公開CI検証結果 検証した問いは「企業間で前の結果が不明なとき、誤った切替えや二重処理をどう防ぐか」です。 模擬企業間の実通信:ローカル環境で模擬企業A・B・Cを別プロセスとして動かし、限定した通知操作 handoff.notice の受入れと相手先の切替えを、40のシナリオで検査しました。 実行条件の再確認:相手先の条件変更、権限の失効、期限切れや遅延した要求を含め、以前の許可をそのまま使い続けないことを検査しました。 結果不明時の保留:応答消失、処理停止、再送などが起きても、前の処理結果が確認できない状態で、別の相手先の処理を進めないことを確認しました。取消しが確定した場合の正常な切替えも試しています。 証拠の再検証:実行側の主要コードを取り込まない別プログラムで、公開された署名付き記録と処理結果の整合性を照合します。署名の確認だけで、業務上の正しさを証明したとは扱いません。 多層の確認:6,144の条件組合せ、38の整数境界、有限状態探索、Leanの抽象モデル検査を行い、対象コミット 7104afa の公開CIでは5ジョブの成功を確認できます。 VPI PoCで示したのは、「結果が分からなければ、同じ業務を別の相手先で進めない」という業務上の安全条件を、模擬企業間の通信試験、限定モデルでの形式検証、公開証拠の再照合という異なる手段から確認できることです。 ただし、各プロセスは同じPC上で動き、企業間の本当の運用独立性はありません。対象の作用はSQLite内の行であり、実貨物の移動やネットワーク経路変更ではありません。検証器が確認するのは開示された記録と所定規則との整合性です。情報が欠けたまま記録一式を作り直す攻撃、侵害された署名鍵、現実の事実との不一致を一律に排除することはできません。 7-3. 2件をどう位置づけるべきか Cold Chain PoC VPI PoC 中心的な問い 引き渡しの実行条件と成功確定 企業間の結果不明・取消し・切替え 検査する主な対象 公開抽象モデル上の操作呼出しと作用、既存署名付き証拠 模擬3社の通信・受信先DBの操作・署名付きイベント 形式検証 37命題、768組のモデル・具体実装の照合 抽象状態遷移の安全条件、具体入力と実行側・検証側の照合 第三者が再検査できるもの 抽象モデルとその計算、開示した証拠の署名・整合性 開示イベントの署名と処理順序・取消し・切替えの整合性 実証していないもの 実WMS・実センサー・実AI接続・本番運用 実企業の独立環境・実物流・耐侵害性・本番AI接続 共通しているのは、「AIや利用者が何を要求したか」と「対象システムが実際に何を許し、どの結果を成功と認めるか」を別々に扱う設計です。これを公表している範囲のテスト・形式検証・証拠照合で示していることが、現段階での技術的な訴求点です。 最も重要なのは、証拠が不十分な操作を止めるだけでなく、結果不明の操作を勝手に失敗扱いして次へ進めないという点です。企業間で業務の主体が変わるほど、この違いは大きくなります。 8. 実運用で越えなければならない5つの課題 実行前の証拠検証は有力ですが、万能ではありません。実運用では少なくとも次の問題が残ります。 証拠の真実性:署名された虚偽データ、侵害された鍵、誤ったセンサー値をどう扱うか。 判定経路の完全性:管理者操作、別API、直接DB更新などでゲートを迂回できないか。 時間差と並行実行:判定と作用の間に条件が変わる問題や、複数操作の競合をどう防ぐか。 結果不明時の継続性:通信断で終端状態が分からないとき、二重作用を防ぎながらどう回復するか。 保証範囲の説明責任:モデル上の証明、テスト結果、実機の観測を混同せず、何が未確認かを示せるか。 「証拠があれば必ず安全」ではなく、確認できないものを確認できた扱いにしないことが、保証の信頼性を左右します。 おわりに:守る対象は「アクセス」から「実行の妥当性」にも広がる ネットワークの入口を守ること。攻撃の兆候を見つけること。主体と権限を検証すること。これらは今後も不可欠です。 ただし、AIエージェントが現実の業務を動かす場面では、さらに一つの問いが必要になります。 その操作は、今この状態で、検証できる根拠に基づいて実行してよいのか。 ここに「境界型・検知型セキュリティの限界」を考える意味があります。既存のセキュリティを否定するためではなく、既存の防御だけでは判断しきれない、実行時点の業務上の正当性を扱うためです。 AIが何を提案するかだけでなく、どの操作を許し、どの操作を止め、どの結果を成功と認めるのか。その条件と根拠を、AIの説明から独立して検査可能にする。 特に重要なのは、操作の返信が失われても、実行がなかったと推測して次の相手へ進めないことです。正規の通信だけで起こり得る二重処理を、業務状態と証拠に基づいて防ぐ。この具体的な課題に対し、公開モデル・模擬企業間通信・再検証可能な証拠を組み合わせて検証していることが、現段階の当社PoCの訴求点です。 それが、AIエージェント時代のサイバーアシュアランスで追求すべき重要な方向だと考えています。 参考文献・一次資料(本文の番号に対応) 以下は、公的機関の原文、原著研究、仕様の公開元、当社の公開実装に限定した資料です。各文献について、本文で何を支えるかと、読み過ぎてはいけない点を併記しました(2026年11月2日時点)。 境界・検知・AIエージェントの脅威 [1] NIST, Zero Trust Architecture, SP 800-207(2020年) csrc.nist.gov ネットワーク境界による暗黙の信頼を排し、個々のリソースへの認証・認可を考えるための基礎文書。ゼロトラストに実行前の認可がない、という主張は本資料と矛盾します。 [2] NIST, Guide to Intrusion Detection and Prevention Systems, SP 800-94(2007年) csrc.nist.gov IDSとIPSの区別を含む原典。検知型が事後検知に限られないことを理解するために使用。古い刊行物のため、2026年の製品性能を比較する根拠にはしません。 [3] Debenedettiほか, AgentDojo: A Dynamic Environment to Evaluate Prompt Injection Attacks and Defenses for LLM Agents, NeurIPS 2024 proceedings.neurips.cc ツール出力を通じたプロンプトインジェクションを評価する査読済み研究。97の通常タスク・629のセキュリティテストケースという評価基盤が重要です。 [4] Dziemianほか, How Vulnerable Are AI Agents to Indirect Prompt Injections? Insights from a Large-Scale Public Competition(2026年、原著プレプリント) arxiv.org 464名、約27万2,000件の攻撃試行、8,648件の成功例を報告。実社会における一般的な侵害率ではなく、特定の競技・評価条件下の結果です。 [5] UK NCSC, Prompt injection is not SQL injection (it may be worse)(2025年12月8日) ncsc.gov.uk 外部データをLLMが誤って指示として扱う危険と、非LLMの決定論的な実行制約の重要性を解説。今回の記事の設計上の中心的な根拠です。 [6] 日本AISI, 『AIインシデントレスポンス・アプローチブック』(2026年1月9日) aisi.go.jp AI特有のインシデントと発見的統制の重要性を整理。事前制御と、検知・対応を組み合わせる必要性の根拠です。 [7] OWASP GenAI Security Project, Top 10 for Agentic Applications 2026(2025年12月公開) genai.owasp.org ASI02のツール悪用、ASI03の権限悪用、ASI08の連鎖的障害などを示す専門家コミュニティのガイダンス。法令や適合認証ではありません。 [8] 日本AISI, 『AIセーフティに関する評価観点ガイド 第1.20版』(2026年7月7日) aisi.go.jp AIエージェント特有の「観測と制御」、自律的な挙動、外部環境との相互作用を評価する国内の一次資料。 [9] NIST, Summary Analysis of Responses to the Request for Information Regarding Security Considerations for AI Agents(2026年5月18日) nist.gov AIエージェント固有の新しい脅威と、既存セキュリティ原則の適応が必要という意見を整理した報告。RFI回答の集約であり、NIST独自の攻撃実験ではありません。 実行制御・検証可能性の先行研究 [10] NIST CSRC, Reference Monitor(NIST SP 800-53 Rev.5由来の用語定義) csrc.nist.gov すべてのアクセスを仲介し、改ざんに耐え、分析・検査可能であるという古典的な要件の確認先。AI実行保証の実装が自動的に同等の保証を得るわけではありません。 [11] Debenedettiほか, Defeating Prompt Injections by Design(IEEE SaTML 2026) ieeexplore.ieee.org CaMeLによる制御フローとデータフローの分離、およびツール呼出し時の制約を示した査読済み研究。設計によってLLMの脆弱性の影響を抑える先行例です。 [12] Wang, Poskitt, Sun, AgentSpec: Customizable Runtime Enforcement for Safe and Reliable LLM Agents(ICSE 2026) conf.researchr.org ルール言語と実行時の安全制約を扱う査読済み研究。報告された有効性は論文の各評価設定に基づきます。 [13] Kaul, Lan, Gupta, AgentBound: Verifiable Behavioral Governance for Autonomous AI Agents(2026年6月、プレプリント) arxiv.org 既存の認可と、個別操作の実行妥当性を区別する先行提案。ガバナンス判断の検証可能な記録を扱います。論文自身が、実測評価結果は今後の公開としています。 [14] Ciliberto, Rudi, Tassi, Proof-Carrying Contracts: Commitments AI Agents Cannot Break(2026年10月、プレプリント) arxiv.org 操作に先立って機械検査可能な証明を要求するProof-Carrying ContractsとAirlockを提案。実世界全体の無条件な安全性ではなく、形式化した制約と信頼前提を確認して読むべき資料です。 [15] OWASP GenAI Security Project, Agent Control Standard (ACS)(2026年9月) genai.owasp.org AIエージェントの実行時フック、制御、追跡を共通化する公開仕様。公開リポジトリ:GenAI-Security-Project/agent-control-standard 。仕様と参照実装の成熟度は区別が必要です。 当社の公開PoC(上記の公的研究とは別区分) [16] 株式会社AIアシュアランス, Cold Chain Cyber Assurance — Public PoC 5.0(2026年) GhostDriftTheory/verifiable-coldchain-cyber-assurance 公開CI:github.com/GhostDriftTheory/verifiable-coldchain-… 公開抽象モデルの形式検証、実装照合、署名付き既存証拠の検査を確認できる資料。実運用全体の保証や第三者認証ではありません。 [17] 株式会社AIアシュアランス, VPI Cyber Assurance v2.0.0-rc2(2026年) GhostDriftTheory/verifiable-physical-internet-cyber-assurance 公開CI:github.com/GhostDriftTheory/verifiable-physical-i… 模擬企業間の通知操作・結果不明時の保留・切替え制御を検証する参照実装。実物流や本番ネットワークの安全性を直接証明するものではありません。 技術比較を補強する追加一次資料 [18] AWS Open Source Blog, Introducing Dogwood: runtime verification for AI agents(2026年8月6日)/Introducing the Dogwood Local Engine: temporal governance for agent actions(2026年9月30日) aws.amazon.com aws.amazon.com 履歴と時間に基づく操作判定、並行するイベントの扱い、再起動後に引き継ぐ状態について、開発元が具体的に説明している一次資料。時系列・状態管理は既存研究にない、という主張を避けるために採用。 [19] Amazon Builders' Library, Malcolm Featonby, Making retries safe with idempotent APIs aws.amazon.com 返信消失・再送・重複作用を防ぐための冪等API設計と、要求識別子を使った整合性維持の一次資料。二重作用防止そのものは新規ではないことを理解するために採用。 [20] AWS Prescriptive Guidance, Saga patterns docs.aws.amazon.com 複数システムにまたがる局所トランザクション、部分障害、補償処理の代表的な既存パターン。VPI PoCの実証対象を既存の分散処理技術と区別するために採用。 [21] ICME Labs, PreFlight — AI Agent Verification with Cryptographic Proof(2026年公開の製品資料) icme.io 実行前の検査とゼロ知識証明による独立照合を提供するとする、開発元の一次資料。独立検証という着想の独占を主張しないための比較対象。公開された製品側の自己説明であり、外部による網羅的な性能・安全性監査結果ではありません。
We ran 736 benchmark tests comparing raw code generation against typed host skills. Compact local models (16B–35B) beat unassisted Claude Sonnet 5 and GPT-6 There is a widespread assumption that if you want an autonomous agent to execute real workflows (interacting with APIs, processing files, extracting data), your only viable choices are frontier cloud models like Claude 3.5/5 or GPT-4o/6, or running an open-weight model with a Python REPL tool and praying it debugs its own code. We just published the results of Skillware-Bench, an empirical benchmark evaluating 23 models across 736 live experimental conditions across 11 model families. We tested two execution rails across four difficulty tiers: 1. Vanilla Baseline: The model writes ad-hoc Python/bash scripts, executes them in a sandbox, reads stderr, and iterates. 2. Skillware Equipped: The model calls pre-compiled, typed Python skill bundles running locally in-process with JIT schema validation. Here is what the empirical data showed: The Parameter Paradox: Across the board, compact sovereign models (16B to 35B) equipped with deterministic skills consistently matched or outperformed unassisted frontier APIs running raw code generation: - Qwen 3.6 35B + skills: 16/16 pass rate, 69k tokens vs Claude Sonnet 5 alone: 14/16 pass rate, 122k tokens (+2 tasks passed, 43% token reduction). - Google Gemma 4 31B + skills: 16/16 pass rate, 43k tokens vs xAI Grok 4.7 alone: 14/16 pass rate, 207k tokens (+2 tasks passed, 79% token reduction). - Meta Llama 4 Maverick + skills: jumped from 37.5% unassisted to 93.8% equipped (+56.2% absolute lift), matching frontier reliability. - Qwen 3.8 Flash (16B) + skills: 16/16 pass rate (100%), beating Claude 5 and GPT-6 Luna alone (both 14/16, 87.5%) at roughly 1/30th the inference cost. Why does raw code synthesis fail so hard? When frontier models write raw code to do things like decode a base64 PDF attachment from an email or verify a corporate entity, they get stuck in recursive debugging loops. Across 368 vanilla runs, models triggered 464 script repair iterations. Once an agent fails its first 4 attempts, the recovery rate collapses: - Attempts 1 to 4: 85% to 100% recovery. - Attempt 8: 50% recovery. - Attempt 9: 33% recovery. - Attempt 12+: 0% recovery floor. The model's context window gets poisoned with stack traces and apologies, causing a terminal failure loop. When you equip a local model with a governed skill, execution logic runs in deterministic Python on the host. The model only has to emit clean JSON arguments. Debugging loops drop from 464 to 0. If you are running local models, you do not need 500B parameters to get enterprise reliability. You need to stop making the model write disposable Python scripts for deterministic operations. All harness code, data, and interactive figures: - Benchmark site: skillware.site - Repository: ARPAHLS/skillware-bench - Core framework: ARPAHLS/skillware
@MarcoPorro Ok, you can follow progress here: ekollof/OmarchyTV-on-kylo Note that dumps/binaries/etc are not pushed to this repo. It contains only docs/information and my own code.
Run Minecraft natively in Rust without Java overhead A clean-room game engine rewrite delivering high performance and programmatic control. horizon-rust/horizon Daily picks: t.me #OpenSource
What could go wrong? Just transfer the guy who oversaw illegally issued visas to "Thai Visa Centre" to oversee an international shipping port instead... On the public repo you go, buddy: github.com/jessuppi/thai-visa-centre/blob/master/… Mr. Atthaphon Sirilatthayakorn, did you leak my info to Chad Scira? t.co
报错先别猜:/debug 的 5 步排错法 (整理自完整版 commands/debug.md 实测文本与 /debug 公开 Gist,非本次新实测;/debug 不在 Lite 免费版、只在完整版。) 程序报错了,不知道哪一行的问题;或者功能“有时候行有时候不行”——/debug 只做一件事:系统性排错,先复现再假设,一次只验证一个假设,不靠猜。 5 步: 1. 复现优先。第一步永远是“写出最小复现步骤”。复现不了就先说“目前无法复现”,列出复现它需要的信息(输入、环境、操作路径),不要直接猜原因。 2. 列假设。基于报错信息和代码,列出 2–4 个可能原因,按可能性排序。每个假设必须附带“如何验证”(一条命令、一个断点、一段最小测试)。 3. 一次验证一个。从最可能的假设开始验证;验证失败就划掉、换下一个,不要同时改多个地方。若第一个假设验证即确认根因,剩余假设可标记“跳过”并说明理由,不必为走流程而走流程。 4. 定位后三问。找到根因后必须回答——①为什么是这里出问题(机制)②为什么之前没发现(测试盲区)③同类问题还有没有(举一反三,grep 同类写法)。 5. 修完验证。修复后重新跑复现步骤,确认现象消失;再跑一遍相关测试,确认没引入回归。 输出长什么样(取自 debug.md 的格式):现象一句话、复现步骤、假设清单(每条带验证方法)、根因(机制解释加代码位置)、修复(改了什么,为什么这样改)、举一反三(同类写法还有几处,是否要一起修)。 什么时候不要用:报错信息都没看、先来问“怎么办”——先把完整报错贴出来;想一次修好三个不相关的 bug——一个现象开一次 /debug;生产环境正在着火——先止血(回滚/降级),再 /debug 找根因;假设验证需要半天——说明拆得不够小,先把验证成本降下来。 示例要点(取自 debug.md 的输入输出示例):输入是 batch_settle 传入 level 缺失的订单时报 KeyError;复现是传入一条缺 level 的订单;根因是直接取字典键无默认值;修复是取键时给默认值;举一反三是 grep 其他直接取值处。 免费先试:Lite 免费版含 /review、/commit、/test 三条命令,双兼容 Claude Code 与 Codex CLI,见 Lite 仓。 完整版含 /debug 在内的 10 条命令,早鸟 ¥9.90(限前 100 份)/正式 ¥19.90,付款后 12 小时内私信交付,7 天无理由退款。国内账号风控提示:优先用 Codex。 链接(文末三链接): - Lite 免费版:alapha888/cn-ai-coding-workflow-lite - 完整版爱发电商品页:afdian.com - /debug 5 条规则公开 Gist:gist.github.com
🎉🏆 Winners of the last week's DevHunt!🎉 Our top 3 champs are: 1⃣🥇@ArticosHQ – best Dev Tool of the week!!! ▶️ devhunt.org 2⃣ github.com/RedditAPIs 🥈 ▶️ devhunt.org 3⃣ Taskless by @thecodedrift 🥉 ▶️ devhunt.org Keep up the great work, everyone!
I built an open MCP server for German employment law, every number with its source I have worked in HR in Germany for more than seven years. I have run over 1,000 interviews and made more than 100 hires. In small companies, the same questions come up every week, usually from a founder who does HR next to everything else: - When does a notice have to arrive so the contract ends this month? - Someone has been sick for three weeks. How long do I keep paying? - What does a minijob cost me compared to a part-time hire? People now ask these questions in Claude or ChatGPT. The text is usually fine. The numbers are the problem: a date or an amount that comes from model memory, with no way to check it. So I built Lintelly Open MCP (in the Claude directory: Lintelly HR Deutschland), an open MCP server for German employment and social insurance law. What it is An MCP server is a set of tools an assistant can call instead of answering from memory. This one covers Germany only, and it is meant for founders and small companies. It has 38 tools in a few groups: - Workflows: ablauf returns a dated workflow for a situation, such as the first hire, onboarding, offboarding, sickness, maternity protection, parental leave, preparing a dismissal, end of probation, end of a fixed term and month-end payroll. - Deadlines: notice periods, the deadline for a dismissal claim, probation, fixed-term contracts, parental leave, maternity protection, retention periods, breaks. - Money: employer costs, minijobs, minimum wage check, continued pay during sickness, payment in lieu of holiday, a rule-of-thumb severance formula, the levy for unfilled disability quota. - Holiday, duties, letters, contracts: holiday entitlement, size thresholds, special dismissal protection, BEM duty, letters such as notices, warnings and references, a library of 126 contract clauses, and a register of 200+ legal values. Every answer has the same shape: ergebnis (result), rechenweg (calculation steps), quellen (norm, official link, check date, status), fallen (common mistakes), naechster_schritt (next step) and hinweis (the disclaimer). Here is a shortened real response from kuendigungsfrist_rechnen for someone who started on 1 September 2023 and receives notice on 20 November 2026: { "ergebnis": { "ende": "2026-12-31", "spaetester_zugang": "2026-11-30", "regel": "1 Monat zum Monatsende", "norm": "§ 622 Abs. 2 BGB" }, "rechenweg": [ "Betriebszugehörigkeit am Zugangstag: 3 volle Jahre.", "Gesetzliche Frist: 1 Monat zum Monatsende (§ 622 Abs. 2 BGB)." ], "quellen": [ { "norm": "§ 622 Abs. 2 BGB", "url": "https://www.gesetze-im-internet.de/bgb/__622.html", "geprueft_am": "2026-10-10", "status": "bestätigt" } ], "hinweis": "Allgemeine Auskunft, keine Rechtsberatung im Einzelfall." } The field names are German because the law is German. The assistant answers in the language of your question. A few design choices: - The server only calculates. It never calls a model. Your assistant writes the text, the numbers come from the tool. - Each legal value has a norm, an official source and a check date. Values are checked against the official text every month. If a check is overdue, the answer says so, and values that are not yet confirmed carry the status "noch nicht bestätigt". - The tools have no fields for names. They take dates, hours, amounts and choices. Inputs are not stored or logged. Only calls per tool and day are counted, with coarse bands such as company size and federal state. How to connect it The remote server is https://hr.lintelly.com/mcp (Streamable HTTP). There is no account, no key and no sign-in. Claude Code: claude mcp add --transport http lintelly-hr-deutschland https://hr.lintelly.com/mcp Claude (web, desktop, mobile): Settings, Connectors, add a custom connector with the address https://hr.lintelly.com/mcp. ChatGPT: Settings, Apps and Connectors, developer mode, create a connector with the address https://hr.lintelly.com/mcp, authentication: none. Gemini CLI: gemini extensions install https://github.com/Lintelly/lintelly-hr-deutschland Local over stdio, for example Claude Desktop or Cursor: { "mcpServers": { "lintelly-hr-deutschland": { "command": "npx", "args": ["-y", "@lintelly/hr-deutschland"] } } } Docker: docker run -i --rm ghcr.io/lintelly/lintelly-hr-deutschland Questions you can ask Ask the way you would ask an HR lead. If something is missing, the assistant should ask back instead of guessing. - "I'm hiring my first employee, 20 hours a week, starting 1 December. What do I need to do?" - "What does a minijob cost me, and what does a part-time employee on 1,800 gross cost?" - "Someone has been sick for three weeks. How long do I pay, and do I get anything back?" - "My employee is pregnant. What applies now?" - "How much holiday does someone with 3 days a week get, and does last year's leave expire?" - "From what size do I need a data protection officer or a works council?" - "What changes for me on 1 January?" The limits This is the part I care about most, as someone who does HR for a living. - It gives information, not legal advice. Every answer is general information, not advice for an individual case. For a dismissal, a warning or a dispute, a person should check whether it fits your case before anything is sent. The tools say this themselves in those answers. For a legal dispute you need an employment lawyer. - Germany only. It does not answer for Austria, Switzerland or anywhere else. - It is only as good as its values. That is why every value shows its source and check date, so you can verify it yourself. Code and feedback The code is MIT, the content is CC BY 4.0, and the repo is here: Lintelly/lintelly-hr-deutschland. Setup for every client is on lintelly.com. If you find a wrong number, a missing case or a bug, please open an issue or write to nick@lintelly.com. Reports of wrong values are the most useful thing you can send me.
Learning to automate Azure with Bash taught me that manual clicking doesn't scale. Read my full narrative on Medium: medium.com github: Walcott-iam/Azure-Deployment-Script #Azure #CloudComputing